
匈牙利算法-MOT任务数据关联问题

前言
对于目标跟踪任务,所要做的就是根据传感器的观测值确定真实目标的数目以及每个目标的对应状态(位置、速度、航向等),在一个完整目标跟踪任务中,一般可以分为三部分:
状态估计
数据关联
航迹管理
其中,数据关联(Data Association)是目标跟踪中最具挑战的任务之一。
对于单目标跟踪而言,数据关联要解决传感器观测值能否与跟踪目标关联上;
对于多目标跟踪而言,数据关联要解决的是传感器的那个观测值该和哪个被跟踪目标关联上。
数据关联已经发展出多种理论算法,如:最近邻、随机有限集、匈牙利算法等。而多目标跟踪数据关联问题可以转化为有权二分图最小权匹配问题,而该问题可以使用匈牙利算法进行求解。
基本概念
图
图(Graph,G),是由顶点集合(Vertices,V)和边集合(Edges,E)组成的二元组,表征了不同顶点间的拓扑连接关系,记作:
$G=(V,E)$
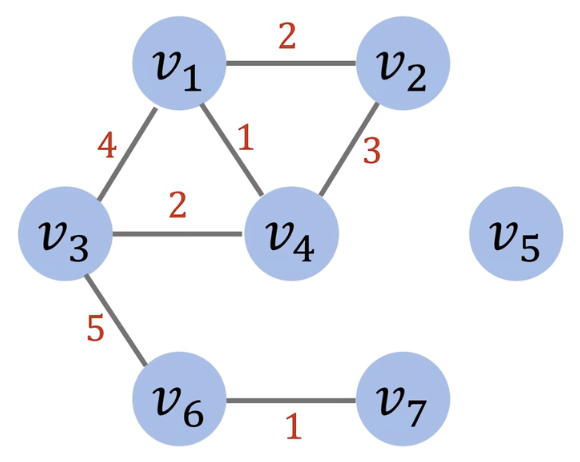
根据图中的边是否具有单向性可将图分为有向图(Directed Graph)和无向图(Undirected Graph),根据图中的边是否具有不同的权重可将图分为有权图(Weighted Graph)和无权图(Unweighted Graph)。本文中将讨论的图都是无向有权图(Undirected Weighted Graph),一个典型的无向有权图如下所示:
二分图
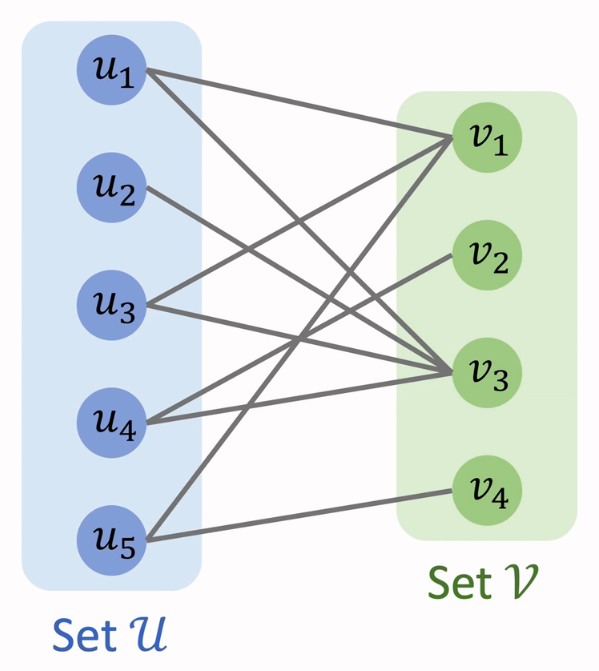
二分图(Bipartite Graph)是一种特殊的图,又称二部图。二分图的顶点集可以被划分为两个互不相交的独立子集 $U$ 和 $V$:
$G=(U,V,E) $
二分图边集合 $E$ 中的每一条边分别连接了顶点子集 $U$ 和 $V$ 中的一个顶点,但 $U$ 和 $V$ 内部的顶点互不相连。一个典型的二分图如下所示:
匹配
给定图 $G=(V,E)$,它的一个匹配(Matching)$M$ 表示包含于边集合 $E$ 的一个子集,即 $M$ 由 $E$ 中的若干条边组成:
$M⊆E$
匹配中的任意两条边之间没有公共顶点。以上面的二分图为例,下图中的两条红色边构成了它的一个匹配:
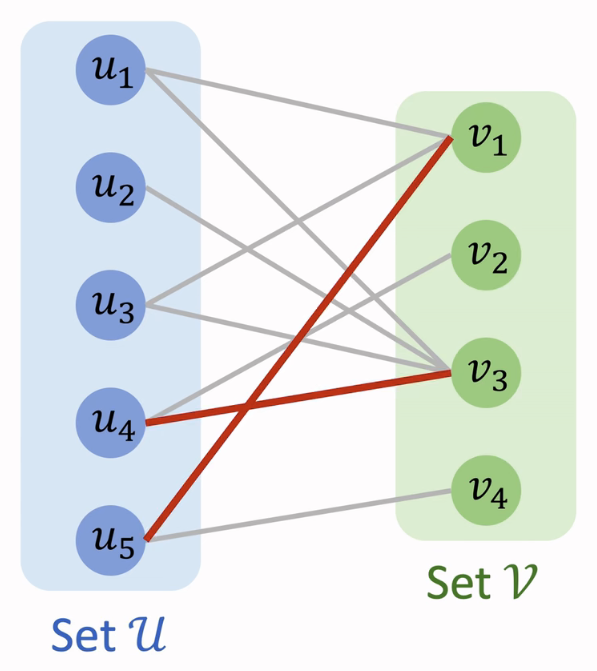
匹配 $M$ 中的边被称为匹配边,上图中的两条红色边都是匹配边;边集合 $E$ 中不属于匹配 $E$ 的边被称为未匹配边,上图中的灰色边都是未匹配边。
匹配边的端点被称为匹配点,上图中顶点 $u_4、u_5、v_1、v_3$ 都是匹配点;顶点集合 $U$ 和 $V$ 中不是匹配边端点的其它顶点被称为未匹配点,上图中顶点 $u_1、u_2、u_3、v_2、v_4$ 都是未匹配点。
最大匹配
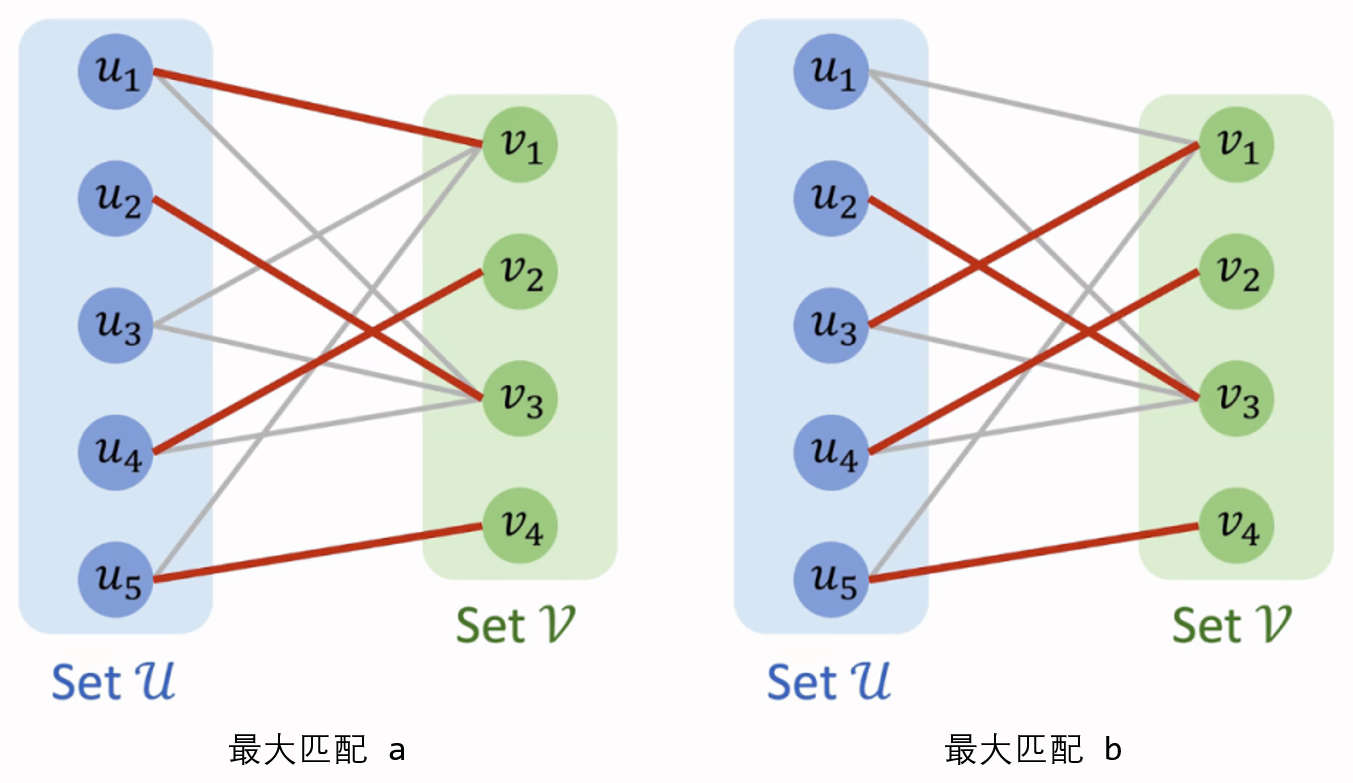
最大匹配(Maximum-Cardinality Matching)表示图的所有匹配中边数最多的那些匹配。最大匹配不唯一,仍以上面的二分图为例,它的最大匹配的边数为 4,下面的两个匹配都是它的最大匹配
最大权匹配和最小权匹配
最大权匹配(Maximum-Weight Matching)表示的是有权图的所有匹配中边的权重之和最大的那些匹配,最小权匹配(Minimum-Weight Matching)表示的是有权图的所有匹配中边的权重之和最小的那些匹配。
仍以上面的二分图为例,我们为它所有的边赋上权重,将其转化为有权二分图
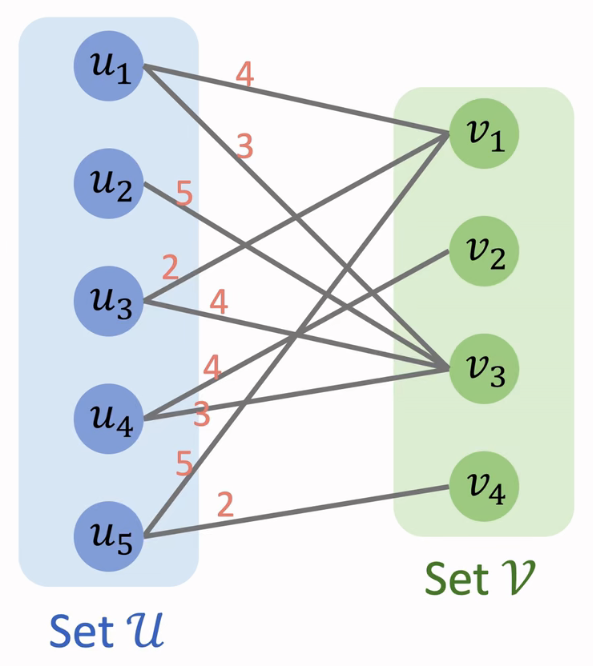
对于上面的有权二分图,我们将任意边上的权重记作 $w$,任意匹配记作 $M$,匹配 $M$ 包含的所有匹配边的权重和记作函数 $f(M)$,则有权二分图的最大权匹配问题和有权二分图的最小权匹配问题可以用如下数学语言进行描述:
$\begin f(M)=\sum_}w_ \ \ max / min f(M) \end$
多目标跟踪数据关联问题可以转化为有权二分图最小权匹配问题,跟踪过程中的航迹序列和量测序列可以分别看作是上面这个有权二分图中的顶点集合 $U$ 和 $V$,边的权重可以看作是航迹和量测间通过某种方式计算得到的匹配距离(例如欧式距离),这个匹配距离我们称之为代价(Cost),所有的匹配距离构成了代价矩阵(Cost Matrix),我们需要做的是,找到航迹和量测间的匹配关系使得总的匹配距离最小(代价最低)。
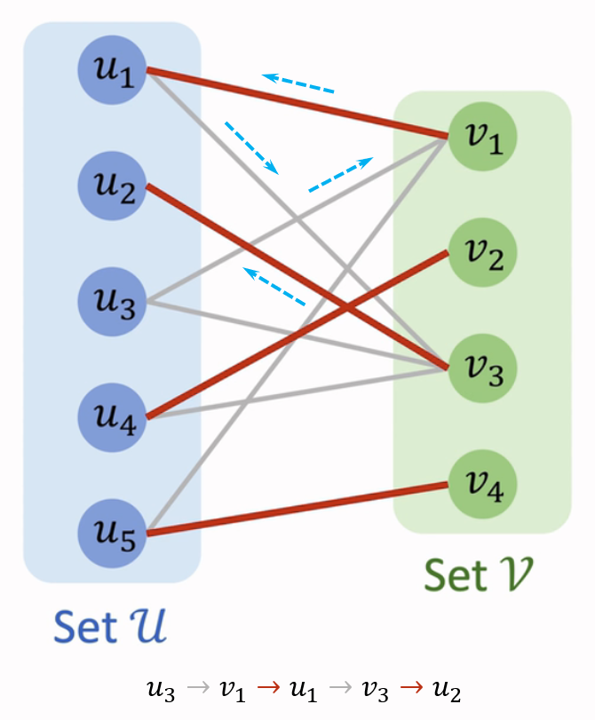
交替路
给定图 $G=(V,E)$ 和它的一个匹配 $M$,交替路(Alternating Path)描述的是图中的这样一条路径:从图中的某个未匹配点出发,交替经过未匹配边和匹配边形成的路径。下面的二分图中,路径 $u_3 → v_1 → u_1 → v_3 → u_2$ 就是一条交替路:
增广路
增广路的概念
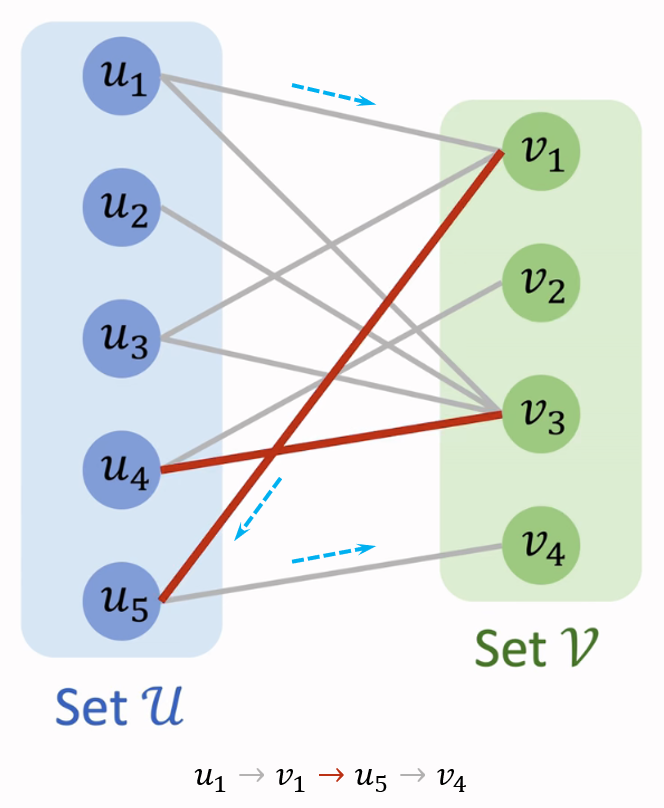
增广路(Augmenting Path)是一条特殊的交替路,增广路从图中的某个未匹配点起始,交替经过未匹配边和匹配边,并终止于不同于起始点的另一个未匹配点。下面的二分图中,路径 $u_1 → v_1 → u_5 → v_4 $就是一条增广路:
增广路的性质
给定图 $G=(V,E)$ 和它的一个匹配 $M$ 以及增广路 $P$,并将 $P$ 上所有的边记作集合 $E_p$,则有如下三个非常重要的性质:
Berge 定理:对于给定的图 $G$ 和它的一个匹配 $M$, $M$是 $G$ 的最大匹配的充要条件是 $G$ 中不存在匹配 $M$ 的增广路 ;
$E_p$ 中边的数量一定为奇数,且增广路 $P$ 的第奇数条边不属于匹配 $M$,第偶数条边属于匹配 $ M$,这意味着, $E_p $中的未匹配边数量一定比匹配边数量多 1;
通过性质 2 不难发现,通过将 $E_p$ 中的未匹配边取反变成匹配边,匹配边取反变成未匹配边,就可以多出 1 条匹配边,取反得到的新匹配边和 $M$ 中不属于 $E_p$ 的剩余边可以构成一个更大的匹配 $M'$。在集合论中, $M'$被称作 $M$ 和 $E_p$ 的对称差,记作 $M⊖E_p$:
$M⊖E_p=(M∪E_p)−(M∩E_p)$
结合性质 1 和性质 3 我们不难发现,对于一个给定的二分图 $G=(U,V,E)$和初始为空的匹配 $M$,我们只要反复搜索增广路就能逐渐扩展匹配的大小,最终当我们找不到增广路时就得到了一个最大匹配,下图中的示例很直观地展示了这个过程:
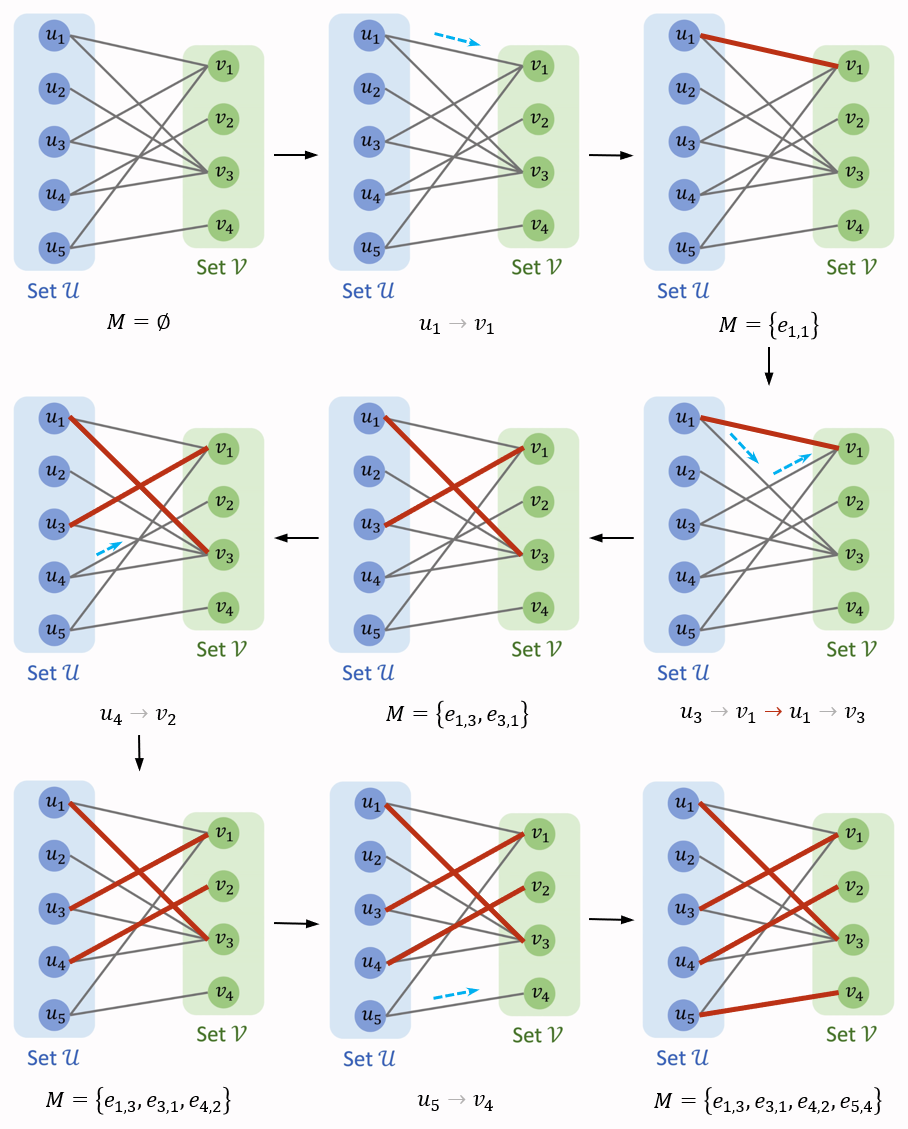
最后得到的 $M={e_, e_ ,e_,e_}$ 就是输入二分图 $G$ 的一个最大匹配。很多资料中使用“婚配问题”为例来讲解上述过程 ,这里我们不再赘述,一句话总结:有机会上,没机会创造机会也要上。