
SOT任务-单目标跟踪算法(Kalman算法)

概述
卡尔曼算法简述
卡尔曼滤波(Kalman Filter)是一种用于递归估计动态系统状态的算法。它在诸如导航、控制系统、经济学、信号处理等领域有广泛应用。卡尔曼滤波器能够在存在噪声和不确定性的情况下,对系统的状态进行准确估计。
卡尔曼滤波器的优点在于其计算效率高,并且能够在实时应用中对系统状态进行快速、准确的估计。然而,卡尔曼滤波器假设噪声是高斯分布的,因此在非高斯噪声或非线性系统中,其性能可能会受到限制。在这种情况下,可以考虑使用扩展卡尔曼滤波(EKF)或无迹卡尔曼滤波(UKF)等改进算法。
目标跟踪算法
对于简单目标的识别我们常常使用传统视觉的识别方案,对于复杂目标以及环境条件下的目标检测我们可以采用深度学习算法解决,当然YOLO是目前公认的较好的目标检测算法。但是无论是对于简单或复杂目标的检测,我们都可能遇到下列的问题:
由于机器人对于目标的要求往往是最符合要求的,而且锁定目标后除了目标消失,一般不会更改目标。
在持续检测的视频流中随时会出现目标个数的增减,最符合要求的目标可能会改变;(目标不确定)
在持续检测的视频流中,对于单个符合条件目标,并不一定每一帧都能被检测出来;(目标不连续)
对于固定性质的目标,如有指定编号的目标,无法确定其性质。(性质无法确定)
那么持续的目标跟踪,就是一个良好的解决方法。
接下来将详细介绍Kalman算法,并且我将结合YOLO算法修改后的输出格式,重点使用Kalman算法去实现对于单个目标的目标跟踪,该实现也应用于RC2024的视觉工程。
使用场景复现
其实目标跟踪算法的使用范围非常广泛,无论你的目标检测使用的是什么算法,如果不结合目标跟踪算法基本上都无法使用,除非你能保证每时每刻对于一种目标都至多能检测出来一个(也就是现实使用场景该目标只有一个)。
结合RC2024的比赛规则来讲述一下目标跟踪的使用场景,对于今年赛规,红蓝双方R2机器人在三区的工作是将在三区暂存区内存放的 红球/蓝球 在 红球/蓝球+紫球 中取出,并放在五个排在一列的谷仓(筐)中,每个谷仓至多放入三个球,R2机器人每次只能在三区暂存区取一个球。
我们看一下在实际过程中我们可能遇到的问题:
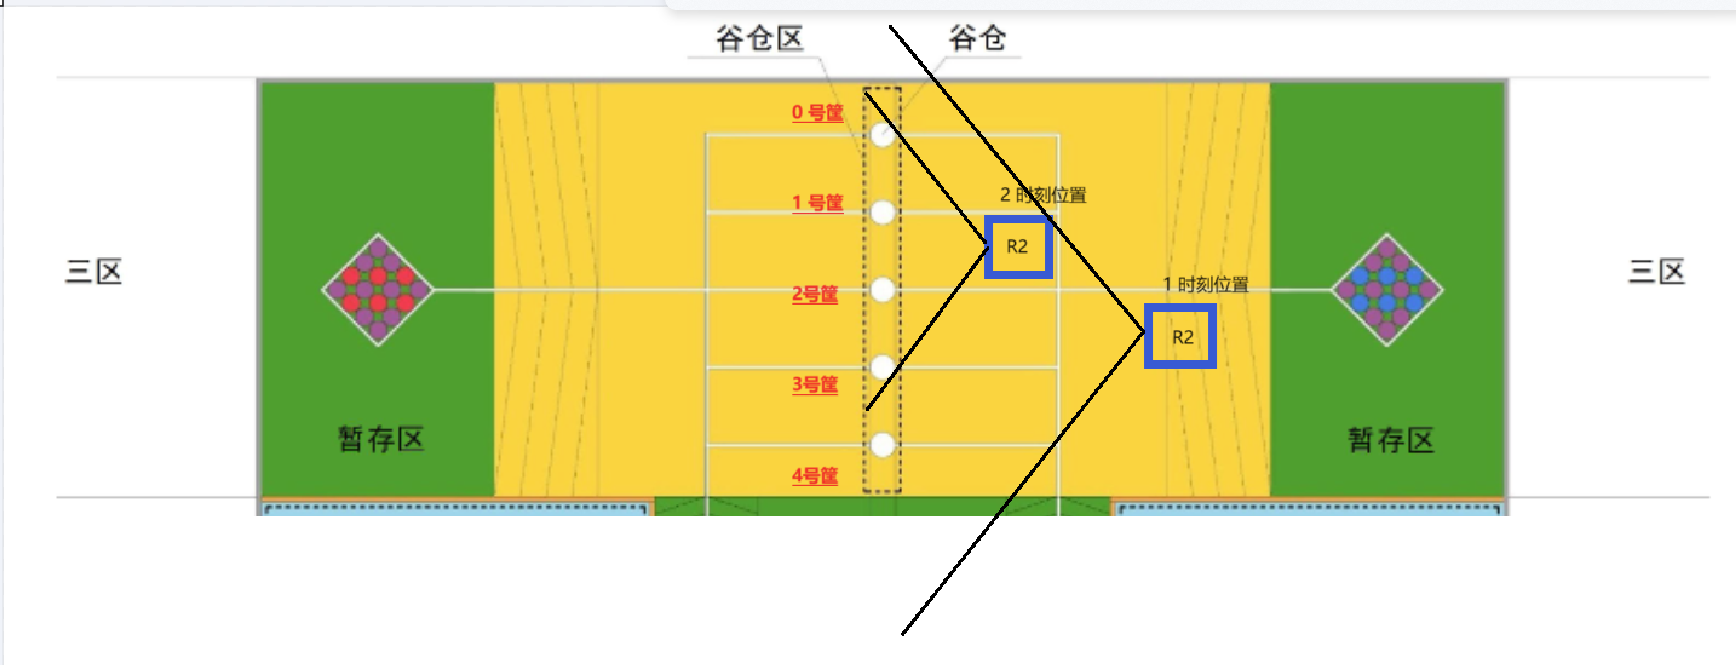
如果我们R2捡到了指定颜色的球,要去到一个合适位置的筐(有的筐是满的,不能去,而且比赛后期有大胜条件),我们一般会给筐进行编号,但是相机的视野范围是固定的,如图所示,在远处我们的相机可以看全五个谷仓和五个谷仓中球的放置情况。
问题一:
假如说,在 1 位置 $t$时刻帧,我们在画面中检测出了五个筐,并且检测出了五个框中球的情况,那么在远处我们可以给画面中的筐进行如图的编号,并且我们可以知道我们该去到哪个筐;但是在 1 位置 $t+\Delta t$($\Delta t$非常小)时刻帧因为目标检测的不稳定性,只检测出了四个筐,那么多个筐的编号就会发生改变。
** ——目标不连续、目标附加性质无法确定、目标不连续**
问题二:
问题一的问题是由目标检测不稳定激发的,事实上这个问题经常出现无论你的模型训练的多好,假如说不会出现这个问题,只要目标出现在画面里就会被全部检测出来。
依旧会出现问题,如图当R2机器人在 1 时刻位置,检测出来了五个筐,并检测出了五个筐中球的情况,那么在远处我们可以给画面中的筐进行如图的编号,并且我们可以知道我们该去到哪个筐;但是,当R2机器人运动到了 2 时刻位置,摄像头视野范围如图,图像里不再有五个筐,那么这个时候,我没有办法再给五个筐进行编号,也就没有办法知道原先想去的目标筐是我画面中的哪个筐,进而更不可能知道,R2在放球这个过程中,目标筐会不会被对方放入球。
——目标不连续、目标性质无法确定
其实产生上述问题总的根本性的原因就是因为没有将视频流不同帧之间的信息进行联系,没有将相邻帧之间目标检测的结果之间相联系,如果我们知道上一帧图像目标检测的一个结果对应着下一帧图像目标检测众多结果中的哪一个,上述问题就得以解决,因而就体现了目标跟踪的重要性。
Kalman目标跟踪效果
https://www.bilibili.com/video/BV1Qf4y1J7D4?vd_source=2a70e8cbccfb71570f2b97be1853e0df
【视频工程】
https://github.com/liuchangji/kalman-filter-in-single-object-tracking
算法理论学习
For Yolo算法
要使用Kalman Filter算法去实现上述的目标跟踪过程,前提是首先要能使用目标检测算法(无论是基于传统视觉还是yolo算法)将画面中对应的目标完成检测,上述视频的工程是以.txt文件的方式,将一个.mp4文件每一帧的person的目标框信息(左上和右下像素点坐标)储存,通过访问文件的形式去获取所有person目标框信息。
我们在使用Kalman Filter算法去实现对单个目标的目标跟踪时,通常结合Yolo目标检测的输出去使用(我使用的是v8版本),因此还是有必要去了解一下Yolov8的输出格式:
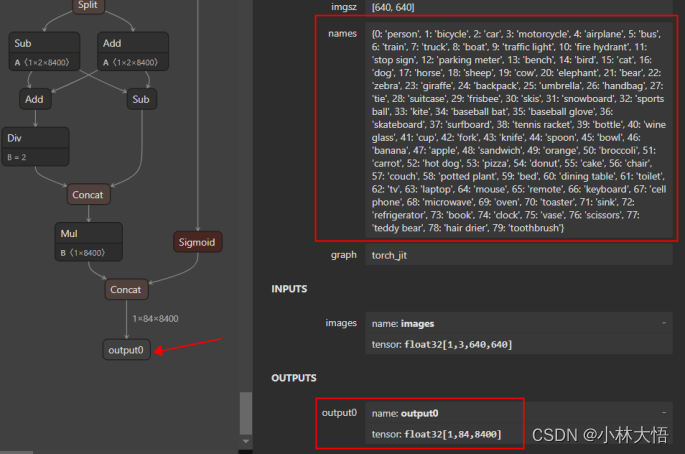
yolov8模型输出格式为**1*84*8400**
**其中1=batch,84=边界框xywh预测4+数据集类别Confidence80,8400代表有8400组数据,每组数据都是84个上述格式。 **具体分布见图二:
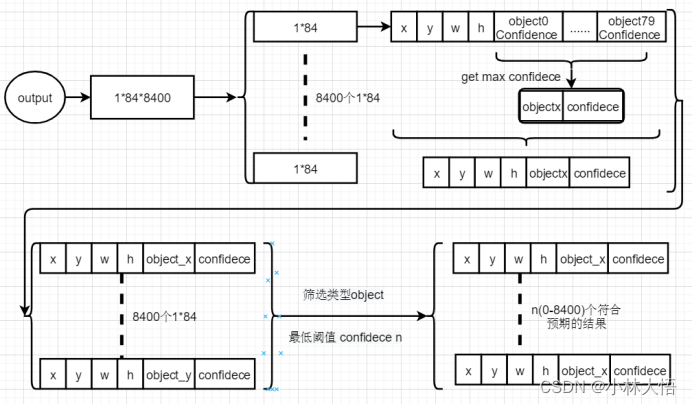
看图上的描述,1*84*8400表示数据的大小,每84个字节为一组,总共8400组数据。解析逻辑可以按照如下逻辑,每读取输出数据的84个字节,前四个字节分别解析为【x,y,w,h】,后面80个字节是不同Class的概率大小。循环8400结束即可。
**理论上:**依据上述对于Yolov8目标检测结果输出的解析,我们可以通过便利输出结果去获取所有检测出来的
”目标类别-预测框”对,进行下面的工作。**实际上:**在实际部署上,我们通常会优化yolov8的输出结构,提升程序运行效率,具体原因和实现方式在yolo算法专题会提到,在这里不过多赘述,知道能获取到什么输出结构的结果。
For IOU算法
IOU(Intersection over Union)算法是一种用于评估目标检测或图像分割模型性能的指标,特别是在计算机视觉领域。它通过比较预测结果与真实标签的重叠程度来衡量模型的准确性,在YOLO模型的运算处理过程中也非常频繁的用到了IOU计算方式,比如:对于置信度Confidence的运算方法中就存在使用IOU的计算方式。
计算公式:
$IOU=\frac$
其中, $|A \cap B|$表示预测框 A 和真实框 B 的交集面积, $|A \cup B| $ 表示它们的并集面积。
IoU的缺点:
敏感性:对于小目标,IoU可能会比较敏感,因为即使有一点点偏移,IoU也会显著降低。
局限性:IoU并不能反映检测框的位置准确性,可能需要结合其他指标(如中心点误差)一起使用。
对于IOU算法,如果我们知道预测框的xywh(yolo的标准输出格式)则有:
代码示例:
#include <algorithm> // for std::max and std::min

struct Box {
    int x, y, w, h;
};

double calculateIoU(const Box& box1, const Box& box2) {
    // 计算交集区域的左上角和右下角坐标
    int x1 = std::max(box1.x, box2.x);
    int y1 = std::max(box1.y, box2.y);
    int x2 = std::min(box1.x + box1.w, box2.x + box2.w);
    int y2 = std::min(box1.y + box1.h, box2.y + box2.h);

    // 计算交集区域的宽度和高度
    int interWidth = x2 - x1;
    int interHeight = y2 - y1;

    // 如果交集区域的宽度或高度为负,则交集面积为0
    if (interWidth <= 0 || interHeight <= 0) {
        return 0.0;
    }

    // 计算交集面积
    int interArea = interWidth * interHeight;

    // 计算每个框的面积
    int box1Area = box1.w * box1.h;
    int box2Area = box2.w * box2.h;

    // 计算并集面积
    int unionArea = box1Area + box2Area - interArea;

    // 计算IoU
    return static_cast<double>(interArea) / unionArea;
}
在这里补充IOU算法的实现的原因:
在使用Kalman Filter目标跟踪时,需要使用到IOU算法在目标检测的众多输出中获取匹配度最优的目标框,IOU值作为匹配度参考;
其实单使用IOU算法也可以写出目标跟踪的算法,思路为此:
用 $t$时刻帧的跟踪目标框和 $t+1 $时刻帧的图像得到的所有同类目标框做IOU计算,取IOU值最大的框对象作为 $t+1$时刻的跟踪目标框,小于一定IOU阈值的,不认为他是更新后的跟踪目标框;大于IOU阈值的取IOU最大的为更新后的跟踪目标框,不断迭代;
如果有相邻 $t+1$帧图像检测出来的所有目标框,都未能与 $t$帧图像的跟踪目标框IOU匹配成功,则 $t+1$帧的跟踪目标框更新方式为: $框_=框_t$ ,往后也是一样;
可以设置阈值,如果连续几帧都未IOU匹配成功,则认为目标跟踪失败。
使用IOU进行目标跟踪算法的代码实现非常简单,这里不再提供源码,可以尝试自己写。
For Kalman Filter算法
以下是本人在学习卡尔曼算法时使用的B站视频教程,以及配套的文档文件,只有当你完成卡尔曼算法的学习,你才能根据算法写出目标跟踪实现,请耐心学完。此外,我会在下面再额外整理一下相关内容公式,争取用最通俗的方式理解并使用Kalman Filter算法。
【视频教程】
1-5集由此进入B站观看
https://www.bilibili.com/video/BV1Rh41117MT?vd_source=2a70e8cbccfb71570f2b97be1853e0df
【视频文档】
【梳理&&使用】
公式梳理
对于Kalman Filter算法公式主要分为预测部分 和 **更新部分 **,整体是处在一个不断循环迭代的过程。
【预测步骤】
状态预测(先验估计):
$\hat=A\hat+B\mu$
误差协方差预测(先验估计):
$P_=AP_A^T+Q$
【更新步骤】
计算卡尔曼增益:
$K=P_H^T(HP_H^T+R)^$
状态更新(后验估计):
$\hat=\hat+K(z_k-H\hat_)$
误差协方差更新(后验估计):
$P_=(I-KH)P_$
观测方程: $z_k=Hx_k+v_k$
是更新步骤的前提,确定$H$,$v_k$是观测噪声
**在 **$k$时刻的预测步骤中:
$\hat_$:是 $k$时刻的状态向量,也是先验状态矩阵。
$\hat_$:是$k-1$时刻更新出的状态向量,也是后验状态矩阵。
$A$:是状态转移矩阵。
$B$:是控制输入矩阵。
$\mu$:是$k $时刻的控制输入向量。
$P_$:是$k$时刻的先验误差协方差矩阵。
$P_$:是$k-1$时刻的后验误差协方差矩阵。
$Q$:是过程噪声协方差矩阵。
**在 **$k$时刻的更新步骤中:
$\hat_$:是 $k$时刻的状态向量,也是先验状态矩阵。
$\hat_$:是$k$时刻更新出的状态向量,也是后验状态矩阵。
$K$:是$k$时刻的卡尔曼增益。
$z_k$:是$k$时刻的观测向量。
$H$:是状态观测矩阵。
$R$:是观测噪声协方差矩阵。
$P_$:是$k$时刻的先验误差协方差矩阵。
$P_$:是$k$时刻的后验误差协方差矩阵。
因此在卡尔曼算法使用过程中是这样的顺序:
$t$:先预测后更新 ——> $t+1$:先预测后更新 ——> $t+2$:先预测后更新——> ... ...
算法使用
确定状态向量,即包括需要使用的表达状态的变量,以及支持这些变量迭代的参数
卡尔曼算法使用的第二步,也是最关键的一步就是,根据实际使用用处列出"状态方程” 和“观测方程”。
列出状态方程,即确定了: $A$状态转移矩阵,$B$控制输入矩阵,$H$:状态观测矩阵。
根据状态方程,确定其他四个方程,这里说一下其他几个位置参数的由来:
$Q$ 描述了系统过程中的不确定性和随机性————实验数据or经验调整;
$R$ 描述了测量中的不确定性和噪声———————传感器特性or实验数据or经验调整;
$\hat、\hat$状态量,可以全初始化为零,也可以看需求初始化(下面实践部分会结合示例细说);
$P_、P_$状态量,一般为对角矩阵,根据对应位置状态的不确定性,不确定性越大值越大,如果所有状态不确定性一致,则为 $CI$ ($C$为常数);
$K$计算得出的量,初始化无意义,如果需要可以任意初始化;
$z_k$测量值,由传感器得出,连续输入;
自此,所有量的由来均得出,卡尔曼公式形成,可以连续迭代。
调参
主要需要调试的参数包括过程噪声协方差矩阵 $Q$ 和观测噪声协方差矩阵 $R$。调参的目标是找到合适的 $Q$ 和 $R$ 以平衡预测和测量之间的权重,从而获得准确的状态估计。
对于$Q$**:**设置较小的值表示对过程变化的信任较高,较大的值表示对过程的不确定性较大。也就是说增大Q值意味着增大过程中的不确定性,预测值更无法被信任;减小Q值意味着对过程变化更加信任,也就是更信任预测值。
$Q \uparrow =$ “对预测值信任减小”
$Q\downarrow =$ “对预测值信任增加”
对于$R$**:**较小的值表示传感器精度高,测量噪声小;较大的值表示测量噪声大,该值描述了测量噪声的不确定性。
$R\uparrow =$ “对测量值信任减小”
$R\downarrow =$ “对测量值信任增加”
算法实践
完成上述对于目标跟踪有关算法的理论学习,我们来看一下如何利用Kalman Filter算法去实现目标跟踪工程。
Kalman方程构建
确定状态向量
我们知道YOLO目标检测模型的输出格式中对于一个目标框的描述向量包含有 $(x,y,w,h)$+ $(ClassesConf)$,表示目标框在画面上位置的向量元素为 $(x,y,w,h)$,因此我们取这部分添加到状态向量中。但是我们知道随着视频帧变化,目标框的位置和尺寸在画面中是连续变化的,仅这四个量无法代表状态的变化,因此我们引入位置变化积分和尺寸变化积分 $(dx,dy,dw,dh)$来完善状态向量,新引入的四个量将相邻帧图像目标框之间构建了联系。
状态向量 $(x,y,w,h,dx,dy,dw,dh)^T$
其中: $\begin dx_k\ dy_k\ dw_k\ dh_k\ \end= \begin x_k-x_\ y_k-y_\ w_k-w_\ h_k-h_\ \end$①
确定 “状态方程” 和 “观测方程”
对于状态方程,我们知道公式 :$\hat=A\hat+B\mu$ 但是对于这个案例来说,相对简单,不存在控制输入,只存在状态的转移。我们在搭建当前时刻先验状态和上一时刻的后验状态关系时发现他们的关系如下:
状态方程
$\begin x_k=x_+dx_ \ y_k=y_+dy_ \ w_k=w_+dw_ \ h_k=h_+dh_ \ dx_k=dx_ \ dy_k=dy_ \ dw_k=dw_ \ dw_k=dw_ \end$ 即
$\begin x_k\ y_k\ w_k\ h_k\ dx_k\ dy_k\ dw_k\ dh_k\ \end=\begin 1&0&0&0&1&0&0&0\ 0&1&0&0&0&1&0&0\ 0&0&1&0&0&0&1&0\ 0&0&0&1&0&0&0&1\ 0&0&0&0&1&0&0&0\ 0&0&0&0&0&1&0&0\ 0&0&0&0&0&0&1&0\ 0&0&0&0&0&0&0&1\ \end\begin x_\ y_\ w_\ h_\ dx_\ dy_\ dw_\ dh_\ \end$
其中:
状态转移矩阵 $A=\begin 1&0&0&0&1&0&0&0\ 0&1&0&0&0&1&0&0\ 0&0&1&0&0&0&1&0\ 0&0&0&1&0&0&0&1\ 0&0&0&0&1&0&0&0\ 0&0&0&0&0&1&0&0\ 0&0&0&0&0&0&1&0\ 0&0&0&0&0&0&0&1\ \end$
控制输入矩阵 $B=0$
观测方程
对于观测方程,我们知道公式: $z_k=Hx_k+v_k$ 这里我们认为观测噪声均值为$0$,也就是符合标准正态分布, 我们取$H=I(8)$ 。
确定参数的初始化
$z_k$ 的后四位每轮迭代前根据①公式算出即可,初始时后四位初始化为$0$;
$P_、P_$ 一般为对角矩阵,因为各个状态量都是yolo模型输出或依靠此计算的结果,所以各量的不确定性几乎一致,权重一致,所以初始值取的 $CI(8)$;
$Q$ 过程噪声协方差矩阵 $p(w)\sim N(0,Q)$,噪声来自真实世界中的不确定性,在跟踪任务当中,过程噪声来自于目标移动的不确定性(突然加速、减速、转弯等);
$R$ 观测噪声协方差矩阵 $p(v)\sim N(0,R)$,观测噪声来自于检测框丢失、重叠等;
$\hat、\hat$这个地方我习惯初始化等于观测值 $z_k(k=0)$,原因是可以可以缩短收敛时间。
理由很简单,如果$\hat、\hat$初始化为$0$当然是可以的,那就意味着卡尔曼预测框,要从$0$收敛到近似于真实值,也就是说,前几帧预测框,真实度会比较低,浪费收敛时间;
如果初始化就是用的第一次的真实值,那么收敛的起点就是第一次真实值的位置,预测框位置的收敛,从启示时刻就是可用的。
目标跟踪程序部分
我们的整个程序还是基于OpenCV4去写的,事实上,一开始在写Kalman跟踪算法时是直接手搓的,OpenCV对于Mat类的运算符重载也是比较完全的,因此直接去写公式也是非常便利的。但是后来发现,OpenCV有自己专门封装好的算法类**cv::KalmanFilter**,也可以扩展为非线性卡尔曼滤波器。
Class KalmanFilter
【cv::KalmanFilter文档】
https://docs.opencv.org/4.10.0/dd/d6a/classcv_1_1KalmanFilter.html#ac0799f0611baee9e7e558f016e4a7b40
构造函数和析构函数
默认构造函数
KalmanFilter()创建一个默认的卡尔曼滤波器对象。
参数化构造函数
KalmanFilter(int dynamParams, int measureParams, int controlParams = 0, int type = CV_32F)dynamParams: 状态向量的维度。measureParams: 观测向量的维度。controlParams: 控制向量的维度(默认为0,如果没有控制输入)。type: 矩阵的数据类型,可以是CV_32F或CV_64F。
公有成员函数
const Mat& correct(const Mat& measurement)更新预测状态,根据测量值更新状态估计。
参数:
measurement: 观测向量。
void init(int dynamParams, int measureParams, int controlParams = 0, int type = CV_32F)初始化/重新初始化卡尔曼滤波器,销毁之前的内容。
参数:
dynamParams: 状态向量的维度。measureParams: 观测向量的维度。controlParams: 控制向量的维度(默认为0)。type: 矩阵的数据类型。
const Mat& predict(const Mat& control = Mat())计算预测的状态。
参数:
control: 可选的控制输入。
公有成员属性
**
controlMatrix****:**控制矩阵 (B),如果没有控制输入则不使用。**
errorCovPost****:**后验误差估计协方差矩阵(P)。**
errorCovPre****:**先验误差估计协方差矩阵(P′)。**
gain****:**卡尔曼增益矩阵(K)。**
measurementMatrix****:**测量矩阵 (H)。**
measurementNoiseCov****:**测量噪声协方差矩阵 (R)。**
processNoiseCov****:**过程噪声协方差矩阵 (Q)。**
statePost****:**后验状态矩阵x(k)。**
statePre****:**预测的状态 x′(k)。**
transitionMatrix****:**状态转移矩阵 (A)。
【示例】
这里不再给出示例代码,来看一个别人KalmanFilter类的使用视频来看一下使用效果:
https://www.bilibili.com/video/BV1WZ4y1q7qq/?share_source=copy_web
Kalman目标跟踪流程
如图流程所示,对于使用Kalman算法进行目标跟踪的过程:
我们首先初始化好根据状态方程和观测方程确定的常量 $A、R、H、Q、B=None$;
在锁定目标的帧,去实例化卡尔曼跟踪对象,并展开迭代过程,迭代过程中输入量为 $k-1$帧后验状态向量和后验协方差 $X_$、$P_$(访问KalmanFilter类的公共成员变量获得),$k$帧的观测值$z_k$(通过用$k$帧模型的检测结果中该类的成员逐个与$k-1$帧目标的后验状态向量(预测值)$X_$中前四位xywh去做IOU匹配获得);
如果当前帧模型检测结果中该类所有目标框与上一帧卡尔曼预测框的IOU匹配均未达到阈值,则认为当前帧模型未检测出被跟踪目标,那么当前帧的观测值用上一帧的卡尔曼预测框代替,同时状态转移矩阵 $A$做出更改为 $A_-$,其中:
| $A_-=\begin;1&0&0&0&1&0&0&0\;0&1&0&0&0&1&0&0\;0&0&1&0&0&0&0&0\;0&0&0&1&0&0&0&0\;0&0&0&0&1&0&0&0\;0&0&0&0&0&1&0&0\;0&0&0&0&0&0&1&0\;0&0&0&0&0&0&0&1\;\end$ | 因为当没有检测出目标时,使用 $X_$代替 $z_k$,状态方程对应为: | $\begin;x_k=x_+dx_ \;y_k=y_+dy_ \;w_k=w_ \;h_k=h_ \;dx_k=dx_ \;dy_k=dy_ \;dw_k=dw_ \;dw_k=dw_;\end$ |
|---|
目标跟踪部分源码
TrackigTarget.h
#pragma once
#ifndef KALMAN_H
#define KALMAN_H

#include"utils.h"  // 引入utils.h头文件
#include"config.h"  // 引入config.h头文件
#include"type.h"  // 引入type.h头文件
#include"func.h"  // 引入func.h头文件
#define LOSSOBJETCT_NUM 10  // 定义LOSOBJETCT_NUM确定目标丢失的容忍次数10

class KalmanTracking {  // 定义KalmanTracking类
public:
    KalmanTracking(Target& Object_First_positionint, int dynamParams, int measureParams, int controlParams);  // 构造函数
    ~KalmanTracking();  // 析构函数

    void Track_Iteration(std::vector<Target>& all_Objects,std::pair<Target,bool>& real_target);  // 跟踪迭代函数

    cv::KalmanFilter KF;  // Kalman滤波器对象
    uint8_t LossObject_index;  // 丢失目标索引
    uint8_t id;  // 目标ID

private:
    cv::Mat Z;  // 状态向量
    cv::Mat A;  // 状态转移矩阵
    cv::Mat A_;  // 状态转移矩阵的转置
};

class Target_Tracker  // 定义Target_Tracker类
{
public:
    Target_Tracker(Target& target_first_position);  // 构造函数

    void is_tracked_normal();  // 判断是否正常跟踪
    void SingleTraget_Tarcking(std::vector<Target>& all_targets, std::pair<Target,bool>& real_target, bool& is_tarck_normal);  // 单目标跟踪函数
    cv::Rect get_PredictTarget_box();  // 获取预测目标框

private:
    bool tracked_normal;  // 是否正常跟踪
    std::unique_ptr<KalmanTracking> tracker;  // KalmanTracking对象的智能指针
};
#endif // !KALMAN_H
TrackimgTarget.cpp
#include"TrackingTarget.h"

// KalmanTracking类的构造函数
// 参数:
// - Object_First_positionint: 目标的初始位置
// - dynamParams: 动态参数的数量,默认为8
// - measureParams: 测量参数的数量,默认为8
// - controlParams: 控制参数的数量,默认为0
KalmanTracking::KalmanTracking(Target& Object_First_positionint, int dynamParams = 8, int measureParams = 8, int controlParams = 0) :
    KF(dynamParams, measureParams, controlParams), LossObject_index(0), id(Object_First_positionint.label)
{
    // 初始化状态转移矩阵A
    A = (Mat_<float>(8, 8) << 1, 0, 0, 0, 1, 0, 0, 0,
        0, 1, 0, 0, 0, 1, 0, 0,
        0, 0, 1, 0, 0, 0, 1, 0,
        0, 0, 0, 1, 0, 0, 0, 1,
        0, 0, 0, 0, 1, 0, 0, 0,
        0, 0, 0, 0, 0, 1, 0, 0,
        0, 0, 0, 0, 0, 0, 1, 0,
        0, 0, 0, 0, 0, 0, 0, 1);

    // 初始化状态转移矩阵A_
    A_ = (Mat_<float>(8, 8) << 1, 0, 0, 0, 1, 0, 0, 0,
        0, 1, 0, 0, 0, 1, 0, 0,
        0, 0, 1, 0, 0, 0, 0, 0,
        0, 0, 0, 1, 0, 0, 0, 0,
        0, 0, 0, 0, 1, 0, 0, 0,
        0, 0, 0, 0, 0, 1, 0, 0,
        0, 0, 0, 0, 0, 0, 1, 0,
        0, 0, 0, 0, 0, 0, 0, 1);

    // 初始化测量矩阵Z
    Z = Mat(measureParams, 1, CV_32F);

    // 设置卡尔曼滤波器的测量矩阵H
    cv::setIdentity(KF.measurementMatrix);

    // 设置卡尔曼滤波器的过程噪声协方差矩阵Q
    cv::setIdentity(KF.processNoiseCov, cv::Scalar::all(0.1));

    // 设置卡尔曼滤波器的测量噪声协方差矩阵R
    cv::setIdentity(KF.measurementNoiseCov, cv::Scalar::all(10));

    // 设置卡尔曼滤波器的后验误差协方差矩阵P
    cv::setIdentity(KF.errorCovPost, cv::Scalar::all(1));

    // 将目标的初始位置转换为状态向量并设置为卡尔曼滤波器的后验状态
    cv::Rect2f rect2f = cv::Rect2f(Object_First_positionint.box);
    KF.statePost = (Mat_<float>(measureParams, 1) << rect2f.x, rect2f.y, rect2f.width, rect2f.height, 0, 0, 0, 0);
}

// KalmanTracking类的析构函数
KalmanTracking::~KalmanTracking() {}

// 进行一次迭代的目标跟踪
// 参数:
// - all_Objects: 所有目标的向量
// - real_target: 实际目标的pair,包含目标和是否找到目标的标志位
void KalmanTracking::Track_Iteration(std::vector<Target>& all_Objects, std::pair<Target, bool>& real_target)
{
    // 初始化最大IOU和最佳目标
    float max_iou = 0.0f;
    Target best_target;
    bool target_found = false;

    // 预测的矩形框
    cv::Rect predicted_rect(
        static_cast<int>(KF.statePost.at<float>(0) + 0.5), static_cast<int>(KF.statePost.at<float>(1) + 0.5),
        static_cast<int>(KF.statePost.at<float>(2) + 0.5), static_cast<int>(KF.statePost.at<float>(3) + 0.5));

    // 遍历所有目标,计算IOU并找到最佳目标
    for (const Target& target : all_Objects) {
        float iou = calculateIOU(predicted_rect, target.box);
        if (iou > max_iou) {
            best_target = target;
            max_iou = iou;
            target_found = true;
        }
    }

    // 如果找到目标
    if (target_found) {
        real_target.first = best_target;
        real_target.second = true;

        // 计算状态向量的增量
        float dx = best_target.box.x - KF.statePost.at<float>(0);
        float dy = best_target.box.y - KF.statePost.at<float>(1);
        float dw = best_target.box.width - KF.statePost.at<float>(2);
        float dh = best_target.box.height - KF.statePost.at<float>(3);
        Z = (Mat_<float>(8, 1) << (float)best_target.box.x, (float)best_target.box.y, (float)best_target.box.width, (float)best_target.box.height, dx, dy, dw, dh);

        // 更新卡尔曼滤波器的状态转移矩阵、预测状态和后验状态
        KF.transitionMatrix = A;
        KF.statePre = KF.predict();
        KF.statePost = KF.correct(Z);

        LossObject_index = 0;
    }
    // 如果未找到目标
    else {
        real_target.first = Target();
        real_target.second = false;

        // 更新卡尔曼滤波器的状态转移矩阵和后验状态
        KF.transitionMatrix = A_;
        KF.statePost = KF.predict();
        LossObject_index++; // 用来记录连续丢失目标的次数,即模型未检测出来被跟踪目标的连续次数
    }
}

// Target_Tracker类的构造函数
// 参数:
// - target_first_position: 目标的初始位置
Target_Tracker::Target_Tracker(Target& target_first_position) :
    tracker(std::make_unique<KalmanTracking>(target_first_position)), tracked_normal(true) {}

// 判断目标是否正常跟踪
void Target_Tracker::is_tracked_normal() {
    if (tracker->LossObject_index > LOSSOBJETCT_NUM) {
        tracked_normal = false;
    }
}

// 单目标跟踪
// 参数:
// - all_targets: 所有目标的向量
// - real_target: 实际目标的pair,包含目标和是否找到目标的标志位
// - is_tarck_normal: 是否正常跟踪的标志位
void Target_Tracker::SingleTraget_Tarcking(std::vector<Target>& all_targets, std::pair<Target, bool>& real_target, bool& is_tarck_normal)
{
    is_tracked_normal();
    if (tracked_normal) {
        tracker->Track_Iteration(all_targets, real_target);
        is_tarck_normal = true;
    }
    else {
        is_tarck_normal = false;
    }
}

// 获取预测目标的矩形框
// 返回值:预测目标的矩形框
cv::Rect Target_Tracker::get_PredictTarget_box()
{
    cv::Rect2f rect2f(
        static_cast<int>(tracker->KF.statePost.at<float>(0) + 0.5), static_cast<int>(tracker->KF.statePost.at<float>(1) + 0.5),
        static_cast<int>(tracker->KF.statePost.at<float>(2) + 0.5), static_cast<int>(tracker->KF.statePost.at<float>(3) + 0.5));
    return cv::Rect(rect2f);
}
Kalman目标跟踪实现效果
假期在家,只找到这个视频,先用这个视频展示吧,后面替换一个效果好一点的,这个没怎么调参,收敛有点慢。
6cccdb8cb5b7d3ba5194d08b29c4e5e5.mp4
事实上如果调参好一点,会比下面这个视频效果还要好一点:
https://www.bilibili.com/video/BV1Kt4y1L71j?vd_source=2a70e8cbccfb71570f2b97be1853e0df