
mutex 与 RAII 锁

多个线程同时运行时,如果它们会访问同一份共享数据,并且其中至少有一个线程会修改这份数据,就必须开始考虑线程同步问题。
C++ 中最基础、最常用的同步工具之一就是:
std::mutexmutex 的中文通常叫:
互斥量
它最核心的作用可以简单理解成:
同一时刻只允许一个线程进入某段需要保护的代码。
这一节重点学习:
什么是共享数据、数据竞争和临界区;
std::mutex到底“锁”的是什么;lock()、try_lock()、unlock();为什么不推荐手动成对调用
lock()/unlock();RAII 为什么特别适合管理锁;
std::lock_guard的基本使用;std::unique_lock为什么更加灵活;std::scoped_lock为什么适合多把锁;什么是死锁,以及怎样避免;
std::recursive_mutex和std::timed_mutex;std::shared_mutex的多读单写;std::call_once的一次性初始化。
为什么需要互斥量
先来看一个最经典的例子:
#include <print>
#include <thread>

int counter = 0;

void add_many()
{
    for (int i = 0; i < 100000; ++i)
    {
        ++counter;
    }
}

int main()
{
    std::thread t1(add_many);
    std::thread t2(add_many);

    t1.join();
    t2.join();

    std::println("{}", counter);
}
运行结果示例(存在数据竞争,实际数字每次可能不同):
104563这里创建了两个线程:
线程 t1
线程 t2
每个线程都执行:
++counter;100000 次。
直觉上:
100000 + 100000 = 200000所以好像最后一定应该输出:
200000但实际上,这段程序存在严重的并发问题。
问题就在:
++counter;++counter 并不是不可分割的一步
我们平时看:
++counter;感觉它就是:
counter 加 1一条操作。
但从程序执行的角度来看,它通常大致需要经历:
读取 counter 当前值
        ↓
当前值 + 1
        ↓
把结果写回 counter
假设现在:
counter = 10两个线程同时执行:
++counter;就可能出现:
线程 A:读取 counter,得到 10
线程 B:读取 counter,得到 10

线程 A:计算 10 + 1 = 11
线程 B:计算 10 + 1 = 11

线程 A:写回 11
线程 B:写回 11
最终:
counter = 11但两个线程明明都执行了一次加法,正确结果应该是:
counter = 12其中一次修改就这样丢失了。
这说明:
即使 C++ 源代码里看起来只有一条语句,也不代表它在多线程环境中天然不可被其他线程干扰。
什么是数据竞争
如果:
多个线程访问同一个内存位置;
至少有一个线程会写;
这些访问之间没有正确的同步;
就可能产生:
数据竞争(Data Race)
前面的:
++counter;就是典型例子。
线程 A 和线程 B 都在:
读取 counter
修改 counter
并且没有任何同步措施。
在 C++ 中,数据竞争通常意味着:
未定义行为(Undefined Behavior)
所以不能只理解成:
“最后结果偶尔少 1。”
真正的问题是:
一旦发生数据竞争,C++ 标准就不再保证程序行为。
因此多线程编程中第一件非常重要的事情就是:
不要让多个线程无保护地同时访问共享可变数据。
什么是临界区
假设有:
++counter;这段代码访问了多个线程共享的变量:
counter并且我们希望:
同一时刻只能有一个线程执行它。
那么这段代码就可以称为:
临界区(Critical Section)
简单理解:
临界区
=
不能让多个线程同时执行的代码区域
例如:
++counter;也可能是一整组操作:
++count;
average = calculate_average();
只要这些操作必须作为一个整体被保护,都可以属于同一个临界区。
std::mutex 基础
std::mutex 到底是什么
mutex 是:
mutual exclusion也就是:
互斥
可以把它想象成一把只有一把钥匙的门锁。
假设有一个房间:
共享数据门口放着:
一把 mutex线程 A 想进去:
线程 A
  ↓
尝试获得 mutex
  ↓
成功
  ↓
进入临界区
此时线程 B 也想进去:
线程 B
  ↓
尝试获得 mutex
  ↓
发现 mutex 已经被 A 持有
  ↓
等待
等线程 A 离开:
线程 A 释放 mutex线程 B 才有机会获得它。
所以 mutex 的核心效果就是:
线程 A ─┐
线程 B ─┼→ 同一时刻只能有一个线程通过
线程 C ─┘
mutex 并不会自动“锁住变量”
这是初学 mutex 时非常容易误解的一点。
例如:
int counter = 0;
std::mutex mutex;
mutex 并不知道:
counter的存在。
它和 counter 之间没有任何自动绑定关系。
例如线程 A:
mutex.lock();
++counter;
mutex.unlock();
但线程 B 如果直接:
++counter;mutex 根本拦不住它。
所以更准确的理解是:
mutex 不是把某个变量锁住,而是让所有遵守同一套加锁规则的线程无法同时进入某段代码。
我们人为规定:
凡是访问 counter
都必须先获得 counter_mutex
这样:
std::mutex counter_mutex;才真正起到了保护 counter 的作用。
std::mutex 的基本使用
std::mutex 定义在:
#include <mutex>最基础的三个操作是:
mutex.lock();
mutex.try_lock();
mutex.unlock();lock():获得锁(不是加锁,是获得锁)
最基本的用法:
mutex.lock();如果当前 mutex 没有被其他线程持有:
mutex 空闲
    ↓
当前线程获得 mutex
    ↓
继续执行
如果 mutex 已经被其他线程持有:
线程 A 已经持有 mutex
          ↓
线程 B 调用 lock()
          ↓
暂时拿不到
          ↓
线程 B 阻塞等待
等线程 A:
mutex.unlock();以后,线程 B 才有机会继续。
所以:
lock();可以简单记成:
拿不到就等。(非常重要)
unlock():释放锁
线程获得 mutex 后:
mutex.lock();完成临界区操作以后,就应该:
mutex.unlock();例如:
mutex.lock();

++counter;

mutex.unlock();
执行过程大致就是:
获得 mutex(获得不了就阻塞,卡在这里)
    ↓
进入临界区
    ↓
修改 counter
    ↓
离开临界区
    ↓
释放 mutex
释放以后,其他等待这把 mutex 的线程才有机会继续执行。
try_lock():拿不到就算了
有些时候,我们并不想:
拿不到锁
↓
一直等(阻塞)
而是希望:
拿得到就执行
拿不到就先干别的(不想阻塞卡在这里)
这时可以使用:
try_lock()例如:
if (mutex.try_lock())
{
    ++counter;

    mutex.unlock();
}
else
{
    // 这一次没有获得 mutex
}
区别可以简单记成:
lock()

拿不到
↓
等待(阻塞)
而:
try_lock()

拿不到
↓
立即返回 false(不会阻塞)
成功时:
true失败时:
false所以:
if (mutex.try_lock())
{
    // 当前线程已经获得锁
}
需要注意,标准允许 try_lock() 偶发性失败。
所以不要把:
try_lock() == false绝对理解成:
现在肯定有另一个线程持有 mutex。
更简单的理解就是:
这次没有获得锁。
用 mutex 修复 counter
之前的数据竞争可以这样解决:
#include <print>
#include <mutex>
#include <thread>

int counter = 0;
std::mutex counter_mutex;

void add_many()
{
    for (int i = 0; i < 100000; ++i)
    {
        counter_mutex.lock();

        ++counter;

        counter_mutex.unlock();
    }
}

int main()
{
    std::thread t1(add_many);
    std::thread t2(add_many);

    t1.join();
    t2.join();

    std::println("{}", counter);
}
运行结果:
200000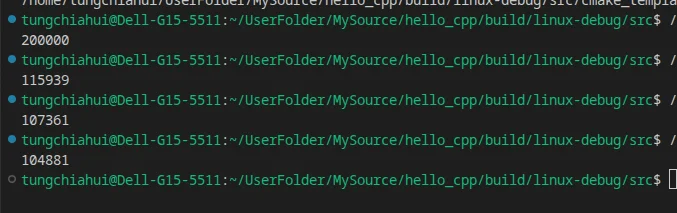
如上图,只有第一个有mutex机制的正确输出了200000,而其他没mutex机制的输出是不固定的。
现在所有想修改:
counter的线程,都必须先:
counter_mutex.lock();于是可能出现:
线程 A 获得 counter_mutex
        ↓
    ++counter
        ↓
线程 A 释放 counter_mutex
        ↓
线程 B 获得 counter_mutex
        ↓
    ++counter
而不会两个线程同时修改。
但是这种写法还有一个很大的问题:
lock();
...
unlock();
完全由程序员自己管理。
为什么不推荐手写 lock() / unlock()
下面这段代码看起来没有什么问题:
mutex.lock();

change_shared_state();

mutex.unlock();
但以后代码可能变成:
mutex.lock();

if (something_wrong())
{
    return;
}

change_shared_state();

mutex.unlock();
如果:
something_wrong()为真:
return;就会直接离开函数。
于是:
mutex.unlock();永远不会执行。
mutex 会一直保持锁定状态。
其他线程如果再:
mutex.lock();就可能一直卡在那里。
还有异常:
mutex.lock();

some_function();

mutex.unlock();
如果:
some_function();抛出异常,后面的:
mutex.unlock();同样不会正常执行。
因此手动管理:
lock()
unlock()
最大的问题就是:
必须保证程序的每一条离开路径都正确释放锁。
代码一复杂,就很容易遗漏。
这很像内存管理里的new和delete所面临的问题,在内存管理中,我们使用的是RAII思路去解决这个问题,也就是智能指针。
在这里,也正是 RAII 特别适合解决的问题。
RAII 锁管理
RAII 为什么适合管理锁
RAII 的核心思想之前已经学过:
让资源的生命周期由对象生命周期管理。
mutex 的所有权也可以看成一种资源。
于是我们希望有这样一个对象:
对象构造
↓
mutex.lock()

对象析构
↓
mutex.unlock()
这样只需要:
{
    某个 RAII 锁对象 lock(mutex);

    // 临界区
}
当作用域结束:
}
↓
lock 对象自动析构
↓
自动释放 mutex
就不需要程序员自己到处写:
unlock();这就是:
RAII 锁
std::lock_guard
最简单、最常用的 RAII 锁之一就是:
std::lock_guard例如:
std::mutex mutex;

void foo()
{
    std::lock_guard<std::mutex> lock(mutex);

    // 临界区
}
执行:
std::lock_guard<std::mutex> lock(mutex);时,可以简单理解成:
lock_guard 构造
        ↓
mutex.lock()
离开作用域时:
lock_guard 析构
        ↓
mutex.unlock()
所以:
void foo()
{
    std::lock_guard<std::mutex> lock(mutex);

    change_shared_state();

} // 自动释放 mutex
不需要再写:
mutex.unlock();用 lock_guard 改写 counter
之前的代码可以写成:
#include <print>
#include <mutex>
#include <thread>

int counter = 0;
std::mutex counter_mutex;

void add_many()
{
    for (int i = 0; i < 100000; ++i)
    {
        std::lock_guard<std::mutex> lock(counter_mutex);

        ++counter;
    }
}

int main()
{
    std::thread t1(add_many);
    std::thread t2(add_many);

    t1.join();
    t2.join();

    std::println("{}", counter);
}
运行结果:
200000每轮循环:
创建 lock_guard
      ↓
获得 counter_mutex
      ↓
++counter
      ↓
这一轮作用域结束
      ↓
lock_guard 析构
      ↓
自动释放 mutex
这样就算以后代码中出现:
return;或者正常的异常栈展开,也不容易忘记释放锁。
C++17 开始还可以利用类模板参数推导写成:
std::lock_guard lock(counter_mutex);不一定必须写:
std::lock_guard<std::mutex>可以用 {} 主动缩小锁的作用域
RAII 锁什么时候释放?
答案就是:
锁对象什么时候析构,mutex 就什么时候释放。
所以我们可以使用 {} 创建一个局部作用域:
void foo()
{
    do_something();

    {
        std::lock_guard lock(mutex);

        change_shared_state();
    }

    do_other_work();
}
执行逻辑:
do_something()

获得 mutex
↓
修改共享数据
↓
释放 mutex

do_other_work()
这样:
do_other_work();就不会继续占着 mutex。
临界区应该尽量小
假设写成:
std::lock_guard lock(mutex);

do_big_calculation();
save_file();
send_network_data();

update_shared_state();
那么整个过程中:
mutex 一直被当前线程持有其他需要这把 mutex 的线程只能:
等待但:
do_big_calculation();
save_file();
send_network_data();
可能根本不需要访问共享数据。
更合理的方式通常是:
do_big_calculation();
save_file();
send_network_data();

{
    std::lock_guard lock(mutex);

    update_shared_state();
}
因此通常应该:
只把真正需要互斥保护的操作放进临界区。
尤其要谨慎在持锁期间执行:
长时间计算;
sleep;文件 IO;
网络 IO;
等待其他线程;
执行耗时未知的函数。
否则其他线程会长时间拿不到锁。
但临界区也不能乱拆
“临界区尽量小”并不是说:
每一行代码都单独加一次锁。
假设有:
int count;
double average;
并且这两个值必须始终保持对应关系。
例如:
++count;
average = calculate_average();
那么这两个操作可能应该属于同一个临界区:
std::lock_guard lock(state_mutex);

++count;
average = calculate_average();
如果拆成:
{
    std::lock_guard lock(state_mutex);
    ++count;
}

{
    std::lock_guard lock(state_mutex);
    average = calculate_average();
}
两次加锁之间,另一个线程可能插进来读取:
新的 count
+
旧的 average
于是看到一个逻辑上不一致的状态。
所以:
临界区应该尽量小,但必须保证一次完整的共享状态修改不会被拆开。
锁保护的是“共享状态”
假设:
struct User
{
    std::string name;
    int age;
};
如果:
name
age
共同组成一个完整的用户状态,那么更合理的是:
std::mutex user_mutex;
User user;
然后:
void update_user()
{
    std::lock_guard lock(user_mutex);

    user.name = "Tom";
    user.age = 20;
}
而不是:
name 一把锁
age 一把锁
所以设计 mutex 时不要只想:
哪一行代码要锁?
更应该考虑:
哪些数据共同组成一个必须保持一致的共享状态?
减少共享数据,通常比疯狂加锁更好
再看这个例子:
for (int i = 0; i < 100000; ++i)
{
    std::lock_guard lock(counter_mutex);
    ++counter;
}
虽然是正确的,但会反复:
lock
unlock
lock
unlock
lock
unlock
...
可以考虑改成:
void add_many()
{
    int local_counter = 0;

    for (int i = 0; i < 100000; ++i)
    {
        ++local_counter;
    }

    std::lock_guard lock(counter_mutex);

    counter += local_counter;
}
这里:
local_counter只被当前线程使用,所以不需要锁。
整个线程先自己完成:
100000 次本地计算最后才:
加一次锁
↓
更新共享 counter
这反映了并发编程中的一个重要思想:
能不共享的数据,就尽量不要共享。
因为:
没有共享
↓
通常也就不需要同步
std::unique_lock (常用)
lock_guard 的特点非常简单:
创建
↓
加锁

销毁
↓
解锁
但有时候我们希望更加灵活。
例如:
先获得锁
↓
读取共享数据
↓
提前释放锁
↓
继续执行耗时操作
这时候可以使用:
std::unique_lock最简单的写法:
std::unique_lock<std::mutex> lock(mutex);和 lock_guard 一样:
构造时获得 mutex
析构时自动释放 mutex
但 unique_lock 提供了更多控制能力。
unique_lock 可以提前解锁
例如:
std::unique_lock lock(mutex);

read_shared_state();

lock.unlock();

do_expensive_work();
执行逻辑:
获得 mutex
↓
访问共享数据
↓
主动释放 mutex
↓
执行耗时操作
而 lock_guard 不提供这种手动解锁能力。
unique_lock 可以再次加锁
例如:
std::unique_lock lock(mutex);

read_shared_state();

lock.unlock();

do_something();

lock.lock();

change_shared_state();
所以 unique_lock 可以进行:
lock
↓
unlock
↓
lock
↓
unlock
不过这种代码越复杂,锁的设计也越容易出问题。
因此只有真的需要这种灵活性时才使用。
延迟加锁:std::defer_lock
默认:
std::unique_lock lock(mutex);会立即获得 mutex。
但可以写:
std::unique_lock lock(mutex, std::defer_lock);此时:
unique_lock 对象已经创建
但是 mutex 还没有被锁住
之后再:
lock.lock();例如:
std::unique_lock lock(mutex, std::defer_lock);

do_something();

lock.lock();

change_shared_state();尝试加锁:std::try_to_lock
还可以:
std::unique_lock lock(mutex, std::try_to_lock);它会尝试获得 mutex,但不会因为暂时拿不到锁而一直等待。
之后可以:
if (lock.owns_lock())
{
    // 已经获得 mutex
}
else
{
    // 当前没有获得 mutex
}
owns_lock()
由于 unique_lock 比较灵活,所以一个:
unique_lock对象不一定始终持有 mutex。
例如:
std::unique_lock lock(mutex, std::defer_lock);刚创建时:
lock.owns_lock()为:
false执行:
lock.lock();以后:
lock.owns_lock()才为:
true如果再:
lock.unlock();又会变回:
falselock_guard 和 unique_lock 怎么选
初学阶段可以直接记:
| 工具 | 特点 | 常见场景 |
|---|---|---|
std::lock_guard | 简单,整个作用域始终持锁 | 普通临界区 |
std::unique_lock | 可以主动解锁、重新加锁、延迟加锁、尝试加锁 | 需要灵活管理锁生命周期 |
所以通常:
普通情况
↓
lock_guard
需要:
unlock()
重新 lock()
defer_lock
try_to_lock
等能力时:
unique_lock不要因为 unique_lock 功能更多,就认为:
它永远比
lock_guard更好。
功能更多也意味着状态更复杂。
能使用简单方案时,一般优先简单方案。
| 项目 | lock_guard | unique_lock |
|---|---|---|
| 自动加锁/解锁 | ✅ | ✅ |
手动 unlock() / lock() | ❌ | ✅ |
| 延迟加锁 | ❌ | ✅ |
try_lock | ❌ | ✅ |
| move | ❌ | ✅ |
condition_variable | ❌ | ✅ |
| 对象大小 | 更小 | 通常更大 |
| 理论运行开销 | 最低 | 略高 |
| 灵活性 | 低 | 高 |
单论效率,std::lock_guard 略高于 std::unique_lock,但通常差距小到基本不用考虑。
死锁与多把锁
什么是死锁
mutex 可以解决很多线程同时访问共享数据的问题。
但如果同时使用多把 mutex,又可能产生新的问题:
死锁(Deadlock),当然不是V社开发的那个游戏死锁。
假设:
std::mutex m1;
std::mutex m2;
线程 A:
void task1()
{
    std::lock_guard lock1(m1);
    std::lock_guard lock2(m2);
}
线程 B:
void task2()
{
    std::lock_guard lock2(m2);
    std::lock_guard lock1(m1);
}
两个线程的锁顺序不同:
线程 A:
m1 → m2

线程 B:
m2 → m1
于是可能发生:
线程 A 获得 m1

线程 B 获得 m2

线程 A 想获得 m2
但是 m2 在线程 B 手里
↓
A 等待 B

线程 B 想获得 m1
但是 m1 在线程 A 手里
↓
B 等待 A
最终:
A 等 B
B 等 A
谁都无法继续。
这就是:
死锁
一个形象的死锁例子
可以把两把 mutex 想象成两根筷子。
两个人吃饭都必须同时拥有:
左筷子
+
右筷子
A 拿到了左筷子。
B 拿到了右筷子。
然后:
A:等 B 放下右筷子

B:等 A 放下左筷子
但两个人谁都不愿意先放下自己已经拿到的筷子。
于是:
谁也吃不上饭这和线程死锁非常类似。
避免死锁:固定加锁顺序
一个非常重要的方法就是:
整个程序规定统一的锁获取顺序。
例如规定:
永远先获得 m1
再获得 m2
那么所有线程都必须:
std::lock_guard lock1(m1);
std::lock_guard lock2(m2);
而不能有些地方写:
m1 → m2另一些地方却写:
m2 → m1统一锁顺序可以避免很多典型死锁。
std::scoped_lock
如果一个操作本来就需要:
同时获得多把 mutex
C++17 提供:
std::scoped_lock例如:
#include <mutex>

std::mutex m1;
std::mutex m2;

void task()
{
    std::scoped_lock lock(m1, m2);

    // 当前同时持有 m1 和 m2
}
它会使用标准库提供的死锁避免策略获取这些锁。
相比:
std::lock_guard lock1(m1);
std::lock_guard lock2(m2);
如果你的意图本来就是:
我要一起拿到 m1 和 m2那么:
std::scoped_lock lock(m1, m2);通常更加直接。
作用域结束以后:
scoped_lock 析构
↓
自动释放它管理的锁
scoped_lock 也可以管理一把锁
它不一定必须传两把以上 mutex。
也可以:
std::scoped_lock lock(mutex);对于一把锁的普通场景,它和:
std::lock_guard lock(mutex);很接近。
初学阶段可以简单记:
普通单锁
→ lock_guard

需要灵活控制
→ unique_lock

同时管理多把锁
→ scoped_lock
std::lock()
C++11 还提供:
std::lock(m1, m2);它可以使用死锁避免算法尝试获取多把可锁对象。
例如:
std::lock(m1, m2);执行成功以后:
m1 已经被当前线程获得
m2 也已经被当前线程获得
接下来通常需要把它们交给 RAII 对象管理。
例如:
std::lock(m1, m2);

std::lock_guard lock1(m1, std::adopt_lock);
std::lock_guard lock2(m2, std::adopt_lock);
这里:
std::adopt_lock可以理解为告诉 lock_guard:
这把 mutex 已经被我提前锁好了,你不要再调用
lock(),只需要从现在开始接管它,最后负责释放。
所以:
std::adopt_lock的前提是:
当前线程必须已经持有这把锁。
C++17 以后,如果只是:
同时获得多把 mutex
+
自动管理它们的生命周期
通常:
std::scoped_lock lock(m1, m2);更加简单。
| 锁 | 单 mutex 性能 | 灵活性 | 多 mutex |
|---|---|---|---|
lock_guard | ⭐⭐⭐⭐⭐ | 低 | 不方便 |
scoped_lock | ⭐⭐⭐⭐⭐ | 低 | 最好 |
unique_lock | ⭐⭐⭐⭐≈ | 最高 | 可配合 std::lock |
其他 mutex 类型
std::recursive_mutex
普通:
std::mutex不适合让同一个线程重复获得同一把 mutex。
例如:
void A()
{
    std::lock_guard lock(mutex);

    B();
}

void B()
{
    std::lock_guard lock(mutex);
}
调用:
A()
↓
已经获得 mutex
↓
A() 调用 B()
↓
B() 又尝试获得同一把 mutex
这会出问题。
如果程序确实需要:
同一个线程重复进入由同一把锁保护的区域
可以使用:
std::recursive_mutex例如:
std::recursive_mutex mutex;它允许同一个线程重复获得这把锁。
不过:
recursive_mutex通常不应该成为第一选择。
如果代码大量依赖递归锁,有时说明:
函数职责
或
锁的边界
设计得过于复杂。
能通过重新整理代码结构避免递归加锁时,通常更加容易维护。
std::timed_mutex
普通:
mutex.lock();可以理解成:
暂时拿不到,就一直等待。
但有时候程序不希望无限等待。
例如:
最多等 100ms这时可以使用:
std::timed_mutex它支持:
try_lock_for()
try_lock_until()
例如:
#include <chrono>
#include <mutex>

std::timed_mutex mutex;

if (mutex.try_lock_for(std::chrono::milliseconds(100)))
{
    // 成功获得 mutex

    mutex.unlock();
}
else
{
    // 在等待时间内没有获得 mutex
}
其中:
try_lock_for()强调:
最多等待多长时间。
例如:
100ms
2s
而:
try_lock_until()强调:
等待到哪个时间点。
它们和之前学习过的:
sleep_for()
sleep_until()
在“相对时间 / 绝对时间”这个思路上比较类似。
std::shared_mutex:多读单写
普通 mutex 有一个特点:
不管你是读数据还是写数据,同一时刻都只能有一个线程持有锁。
假设程序里有:
std::string config;很多线程都只是:
读取 config真正修改它的情况非常少。
如果使用普通 mutex:
线程 A 读
↓
线程 B 即使也只是读
也必须等待
但:
读 + 读通常并不会互相破坏数据。
真正危险的是:
读 + 写或者:
写 + 写所以 C++17 提供:
std::shared_mutex它可以支持:
多个读线程同时进入,但写线程必须独占。
shared_lock 和 unique_lock
使用 shared_mutex 时:
读取通常使用:
std::shared_lock写入通常使用:
std::unique_lock例如:
#include <mutex>
#include <shared_mutex>
#include <string>

std::string config;
std::shared_mutex config_mutex;

std::string read_config()
{
    std::shared_lock lock(config_mutex);

    return config;
}

void write_config(std::string value)
{
    std::unique_lock lock(config_mutex);

    config = std::move(value);
}
多个线程都读取:
线程 A:shared_lock
线程 B:shared_lock
线程 C:shared_lock
可以同时存在。
但是写线程:
std::unique_lock lock(config_mutex);必须独占。
可以简单记成:
shared_lock + shared_lock
✓ 可以同时存在

shared_lock + unique_lock
✗ 不可以

unique_lock + unique_lock
✗ 不可以
这就是:
多读单写。
为什么读取也可能需要锁
有一种很常见的错误写法:
void write()
{
    std::lock_guard lock(mutex);

    value = 10;
}

int read()
{
    return value;
}
有人会觉得:
写的时候加锁就够了,读又不会修改变量。
实际上并不是。
如果:
线程 A 正在写 value同时:
线程 B 正在读 value仍然可能产生数据竞争。
所以:
如果共享数据存在并发写入,那么对应的读取通常也必须参与同一套同步规则。
不能只锁写,不管读。
shared_mutex 不一定比普通 mutex 更快
看到:
多个线程可以同时读很容易产生一个误解:
那以后全部用 shared_mutex 不就好了?
实际上 shared_mutex 自己需要维护更加复杂的状态,例如:
现在有几个读线程?
有没有写线程?
什么时候允许写线程进入?
这些本身都有额外开销。
所以:
std::shared_mutex比较适合:
读很多
写很少
并且确实存在大量并发读取
的场景。
不要简单认为:
shared_mutex 一定比 mutex 快它们只是适用场景不同。
一次性初始化
std::call_once
还有一类特殊的多线程需求:
某段初始化代码只能成功执行一次。
例如:
initialize();可能有三个线程同时第一次进入:
线程 A
线程 B
线程 C
但我们希望:
initialize()最终只成功完成一次。
标准库提供:
std::once_flag
std::call_once
例如:
#include <print>
#include <mutex>
#include <thread>

std::once_flag flag;

void initialize()
{
    std::println("initialize once");
}

void worker()
{
    std::call_once(flag, initialize);
}

int main()
{
    std::thread t1(worker);
    std::thread t2(worker);
    std::thread t3(worker);

    t1.join();
    t2.join();
    t3.join();
}
运行结果:
initialize once三个线程都会执行:
std::call_once(flag, initialize);但:
initialize();只会成功完成一次。
可以粗略理解成:
线程 A ─┐
线程 B ─┼→ call_once → initialize 成功一次
线程 C ─┘
如果初始化函数执行过程中抛出异常,这一次不会被认为已经成功完成,后续调用仍然可以再次尝试。
函数局部 static 初始化也是线程安全的
C++11 开始:
MyObject& instance()
{
    static MyObject object;

    return object;
}
这里:
static MyObject object;的初始化本身已经具有线程安全保证。
所以如果目的只是:
延迟初始化一个函数内部的 static 对象
通常不需要额外再写:
std::call_once工程实践 (重要)
最好把 mutex 和它保护的数据封装在一起
不推荐设计成:
函数 A:
调用前必须先锁 mutex

函数 B:
自己内部会锁

函数 C:
只能在已经持锁时调用

函数 D:
有时候锁,有时候不锁
代码一多以后,很容易变成:
到底谁负责加锁?
更好的设计通常是:
让拥有共享数据的类自己管理同步。
例如:
class Counter
{
public:
    void increment()
    {
        std::lock_guard lock(mutex_);

        ++value_;
    }

    int get() const
    {
        std::lock_guard lock(mutex_);

        return value_;
    }

private:
    mutable std::mutex mutex_;
    int value_ = 0;
};
外部只需要:
counter.increment();并不需要知道:
内部用了哪把 mutex
什么时候 lock
什么时候 unlock
这样同步规则更加集中,也更不容易漏锁。
为什么 mutex 经常写成 mutable (重要)
前面的:
int get() const是一个 const 成员函数。
但是对 mutex:
mutex_.lock();
mutex_.unlock();
会修改 mutex 自己的内部状态。
所以通常写:
mutable std::mutex mutex_;这样即使当前成员函数是:
const仍然可以对 mutex 加锁。
这并不意味着:
get()真的修改了 Counter 对外表现出来的逻辑状态。
它只是修改了内部的同步状态。
所以 mutex 写成:
mutable是非常常见的做法。
持锁时不要随便调用未知代码
例如:
std::lock_guard lock(mutex);

some_callback();
如果:
some_callback();内部又尝试获得:
mutex或者又获得其他 mutex,就可能产生非常复杂的锁依赖关系。
因此一个很实用的原则是:
持锁期间尽量不要调用锁行为未知的外部代码。
特别是:
回调函数
虚函数
第三方复杂函数
用户传入函数
都应该谨慎。
三种常用 RAII 锁怎么记
初学阶段可以记成:
std::lock_guard
│
├─ 简单
├─ 构造时加锁
├─ 析构时解锁
└─ 普通单锁场景优先考虑
std::unique_lock
│
├─ 更灵活
├─ 可以 unlock()
├─ 可以重新 lock()
├─ 支持 defer_lock
└─ 支持 try_to_lockstd::scoped_lock
│
├─ C++17
├─ RAII
├─ 可以管理一把锁
└─ 特别适合同时管理多把锁最简单的记忆方式:
普通单锁
→ lock_guard

灵活控制
→ unique_lock

同时多锁
→ scoped_lock
常见错误
只给写操作加锁
void write()
{
    std::lock_guard lock(mutex);

    value = 10;
}

int read()
{
    return value;
}
如果存在并发写入,无同步读取同样可能产生数据竞争。
手动 lock() 后忘记 unlock()
例如:
mutex.lock();

if (error)
{
    return;
}

mutex.unlock();
因此普通场景优先使用 RAII 锁。
多把锁的顺序不一致
线程 A:
m1 → m2

线程 B:
m2 → m1
可能导致死锁。
临界区太大
例如:
std::lock_guard lock(mutex);

sleep();
network_io();
file_io();
big_calculation();
其他线程可能长时间无法获得 mutex。
临界区太小
本来应该整体更新的数据被拆开:
锁
修改 A
解锁

锁
修改 B
解锁
可能让其他线程在中间看到不一致状态。
持锁调用未知函数
std::lock_guard lock(mutex);

callback();
如果 callback 内部又涉及锁,可能造成死锁或复杂锁依赖。
为了“安全”到处加锁
锁不是越多越安全。
锁越多,可能带来:
更复杂的锁关系
↓
更多线程竞争
↓
更差的性能
↓
更高的死锁风险
真正应该做的是:
明确哪一份共享状态由哪一把 mutex 保护。
认为 mutex 会自动保护变量
下面:
std::mutex mutex;
int counter;
并不会自动建立:
mutex 保护 counter的关系。
必须让所有线程遵守:
访问 counter 前
必须按照约定获得 mutex
mutex 才真正起作用。
认为 shared_mutex 一定更快
shared_mutex 允许多个线程同时读,但管理成本也更高。
只有真正:
读很多
写很少
存在明显并发读取需求
时才值得考虑。
最重要的 mutex 心智模型
看到:
std::mutex mutex;不要简单理解成:
创建了一把可以锁变量的锁。
更好的理解是:
创建了一个多个线程竞争“进入某段临界区资格”的同步对象。
看到:
std::lock_guard lock(mutex);可以理解成:
线程想进入临界区
        ↓
先获得 mutex
        ↓
获得成功
        ↓
进入临界区
        ↓
离开作用域
        ↓
自动释放 mutex
其他线程:
暂时拿不到 mutex
↓
不能同时进入
这才是 mutex 最核心的思想。
小结
std::mutex 最核心的作用是:
让多个线程互斥访问共享可变状态。
最基础的三个操作:
lock()
try_lock()
unlock()
但实际开发中,普通场景不推荐手动写:
mutex.lock();

...

mutex.unlock();
而应该优先让 RAII 对象管理锁。
普通单锁场景:
std::lock_guard需要更加灵活地控制锁生命周期:
std::unique_lock需要同时管理多把锁:
std::scoped_lock需要多读单写:
std::shared_mutex需要带超时地等待:
std::timed_mutex确实需要同一个线程重复进入同一个临界区时:
std::recursive_mutex需要让某段初始化逻辑只成功执行一次:
std::call_once并发代码中真正需要思考的,通常不是:
mutex API 怎么写?而是:
哪些数据会被多个线程共享?
哪些操作必须作为一个整体?
哪把 mutex 负责保护这些状态?
临界区应该有多大?
有没有同时获取多把锁?
不同地方的锁顺序是否一致?
把这些问题想明白以后,mutex 本身的代码通常反而并不复杂。
对于“单个简单共享变量”的同步,以及“让线程等待某个条件发生”这两类问题,后面的 std::atomic 和 std::condition_variable 章节会分别继续介绍。