
Detect模型性能评价-基于Yolo

概念补充
**真阳性(True Positives, TP)**真实为真,模型预测结果为真;
**假阴性(False Negatives, FN)**真实为真,模型预测结果为假;
**假阳性(False Positives, FP)**真实为假,模型预测结果为真;
真阴性(True Negatives, FN):真实为假,模型预测结果为假;
精确率 $Precision= TP+FP}$;
**召回率 **$Recall= TP+FN}$;
**置信度 **$Confidence$ 是指模型对某个预测框内是否存在目标的置信程度,是介于 0 和 1 之间的概率值;
精确率是模型所有预测为真的结果中,预测正确的占比;------体现了模型对真的判断精准性
召回率是所有为真的样本被模型预测出来的占比; ------体现了模型对真的**检测覆盖性 **
一、模型评价指标
Confusion Matrix && Confusion Matrix Normalized
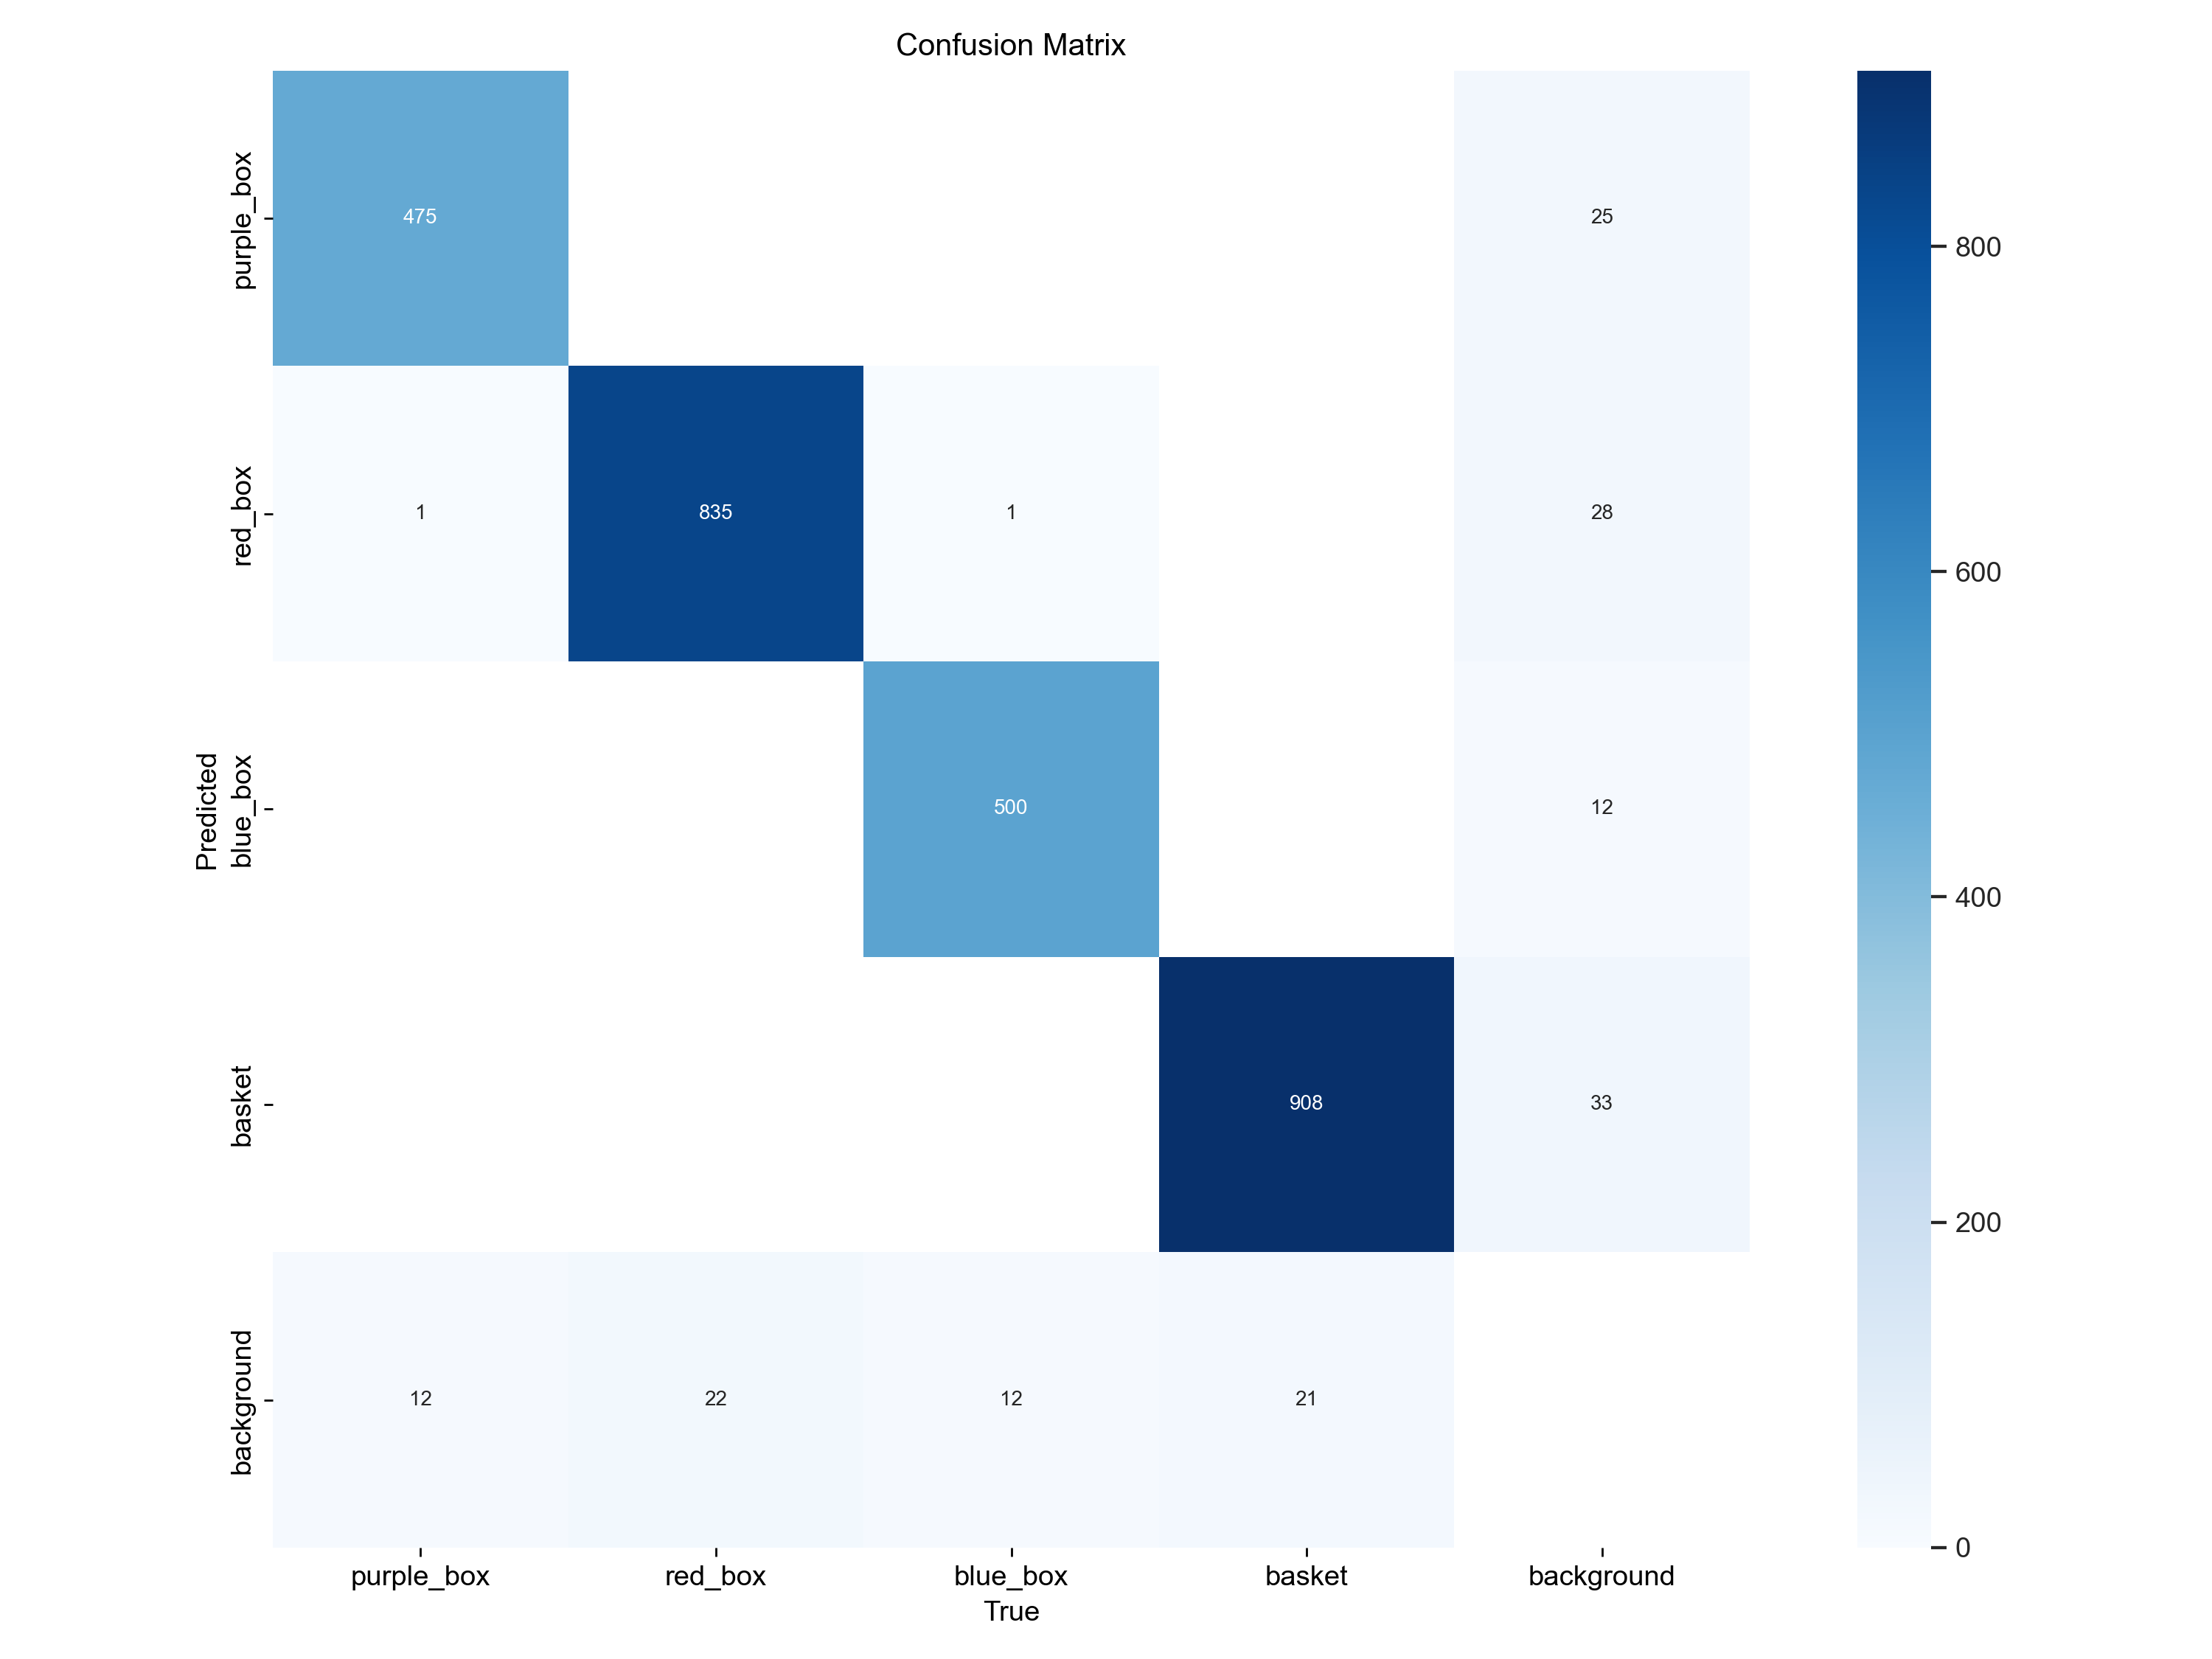
原始混淆矩阵
原始混淆矩阵,用于评估目标检测模型的分类性能。
定义:原始混淆矩阵显示的是每个类别的真实标签和预测标签之间的数量关系。矩阵的每个元素表示对应类别的预测结果与实际标签的匹配情况。
横轴和纵轴:横轴通常表示模型预测的类别(Predicted Class),纵轴表示实际的类别(True Class)。
数值含义:矩阵的对角线元素代表模型预测标签和真实标签相同的情况,非对角线元素则表示模型预测标签和真实标签不相同的情况。故矩阵分布越靠近对角线元素,代表模型的分类能力越好。
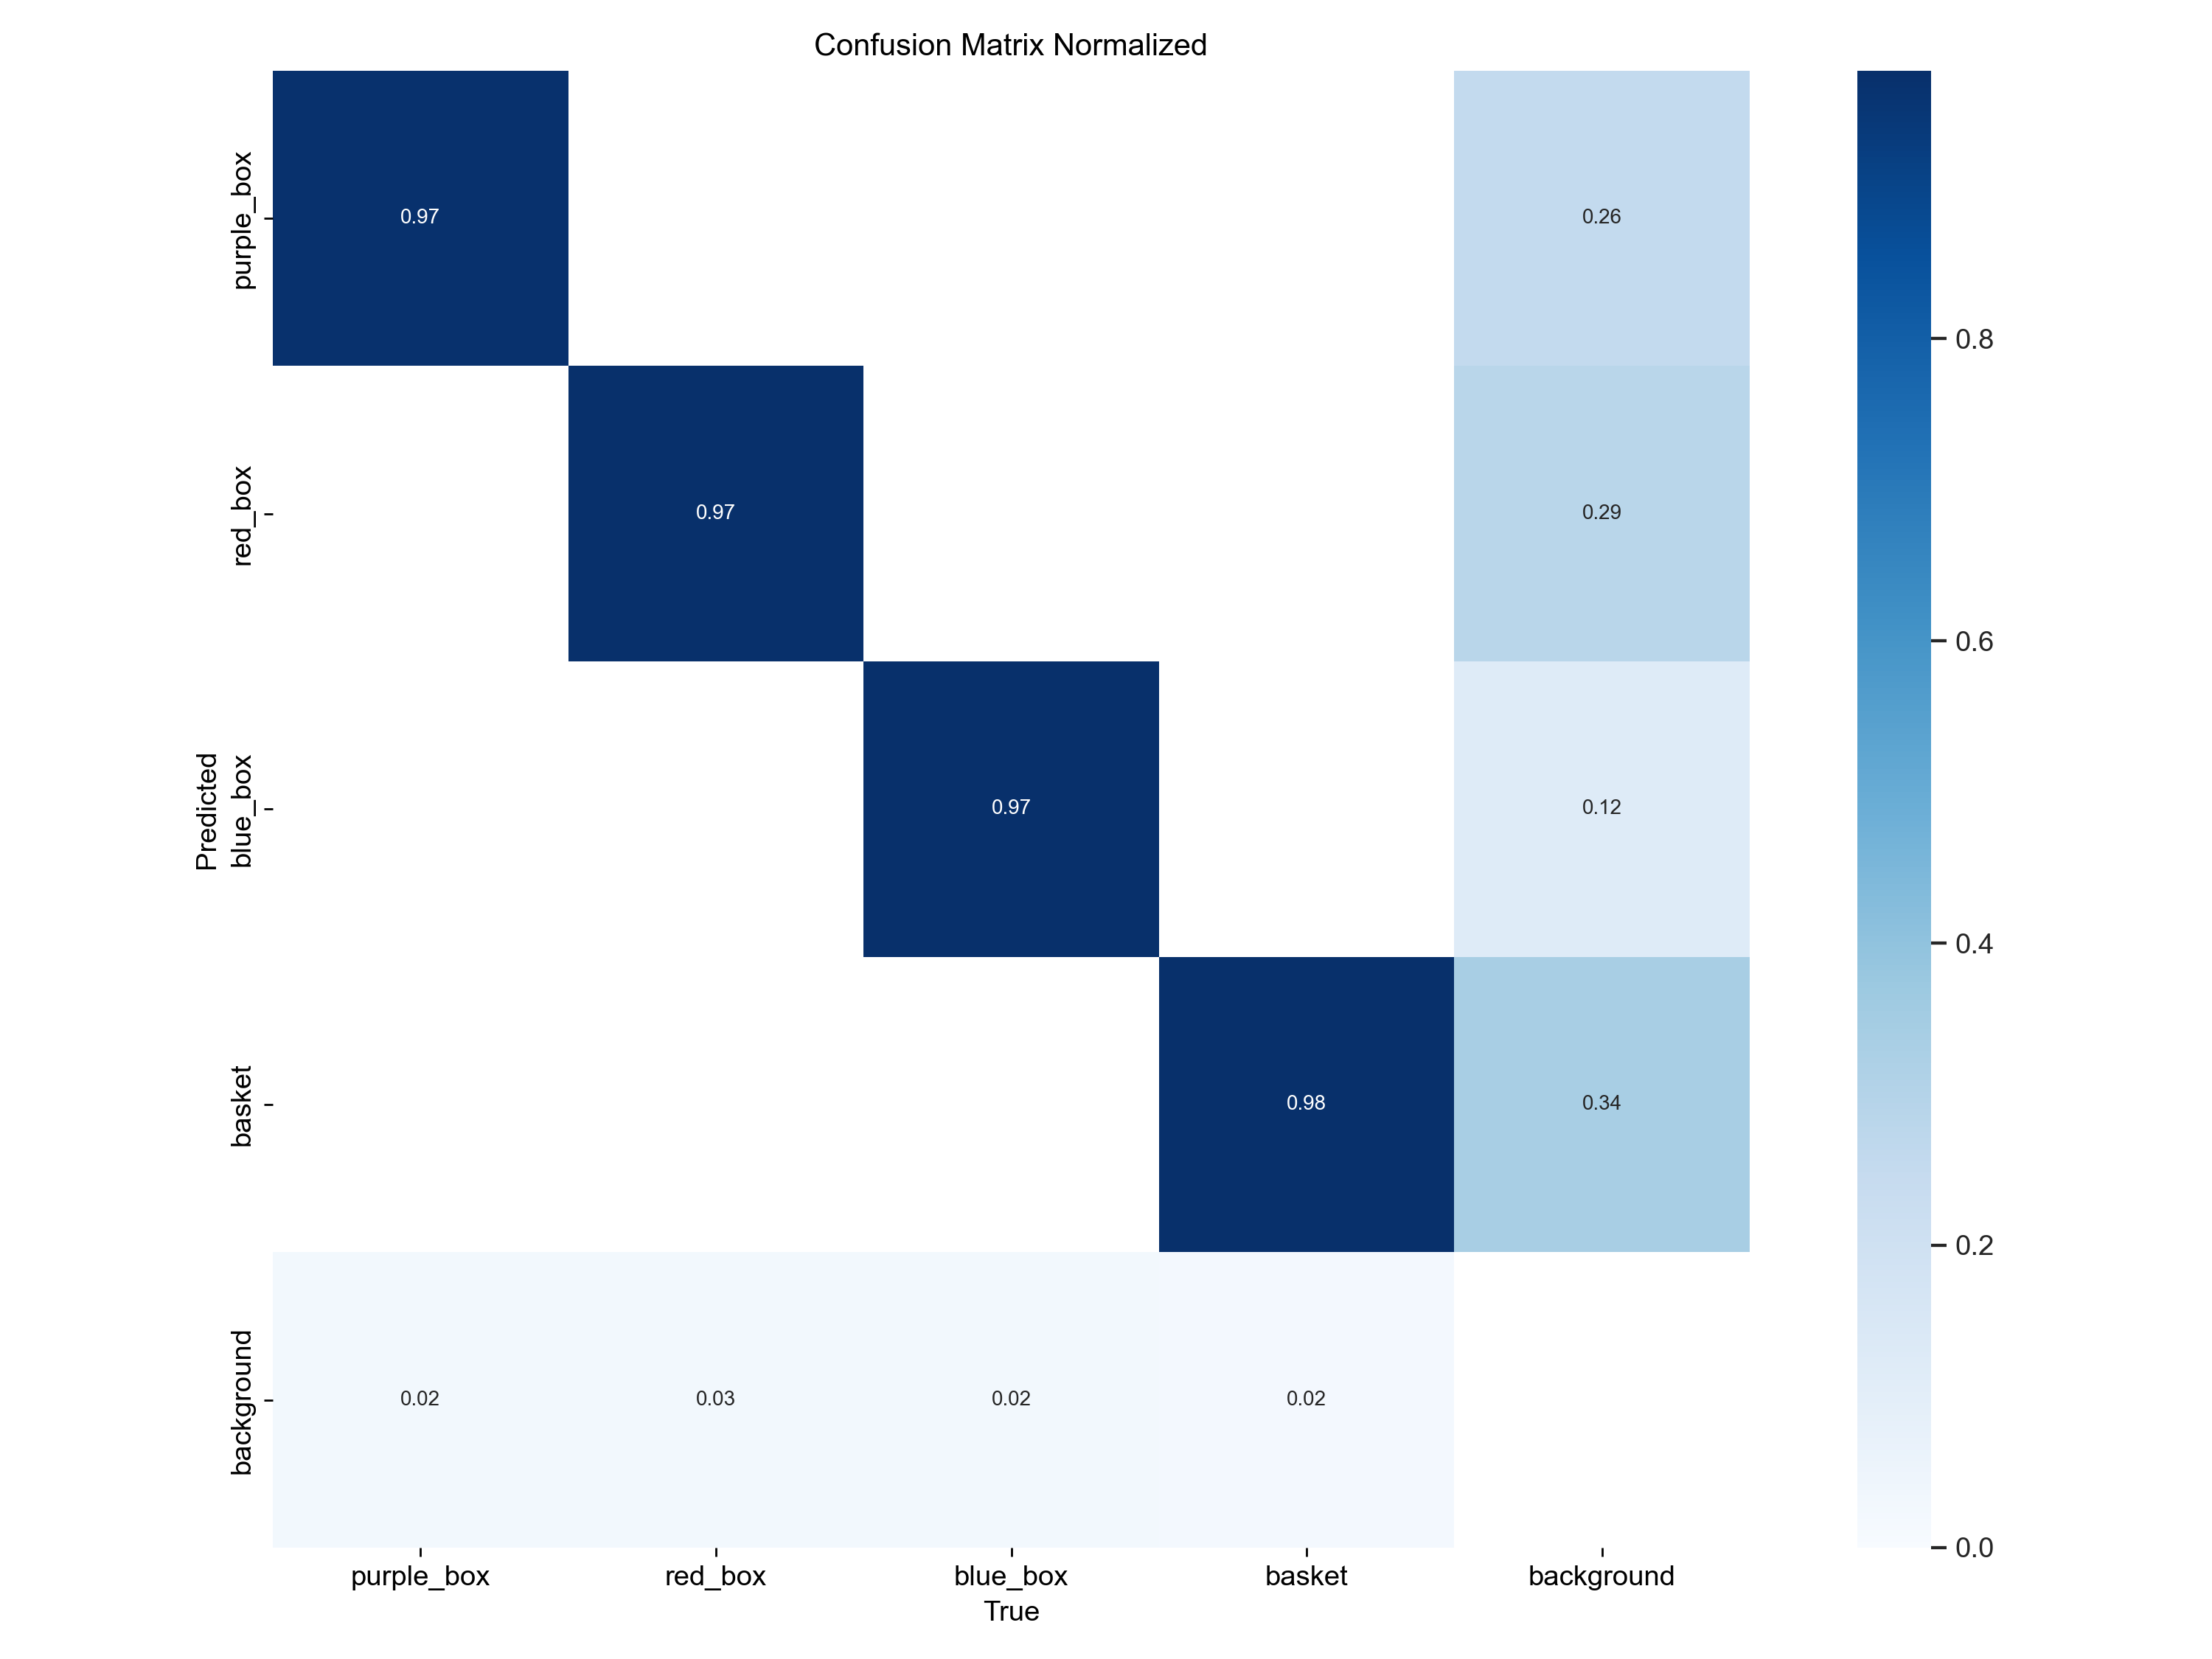
归一化混淆矩阵
是原始混淆矩阵归一化后的结果,归一化的目的是为了看出那个类别分类出现错误的比重大(每列的数值总和为 1 ),从而可以看出模型对哪个类别的分类能力差,可以对应修改数据集或者模型参数,改进模型性能。
F1-Confindence Curve(F1分数)
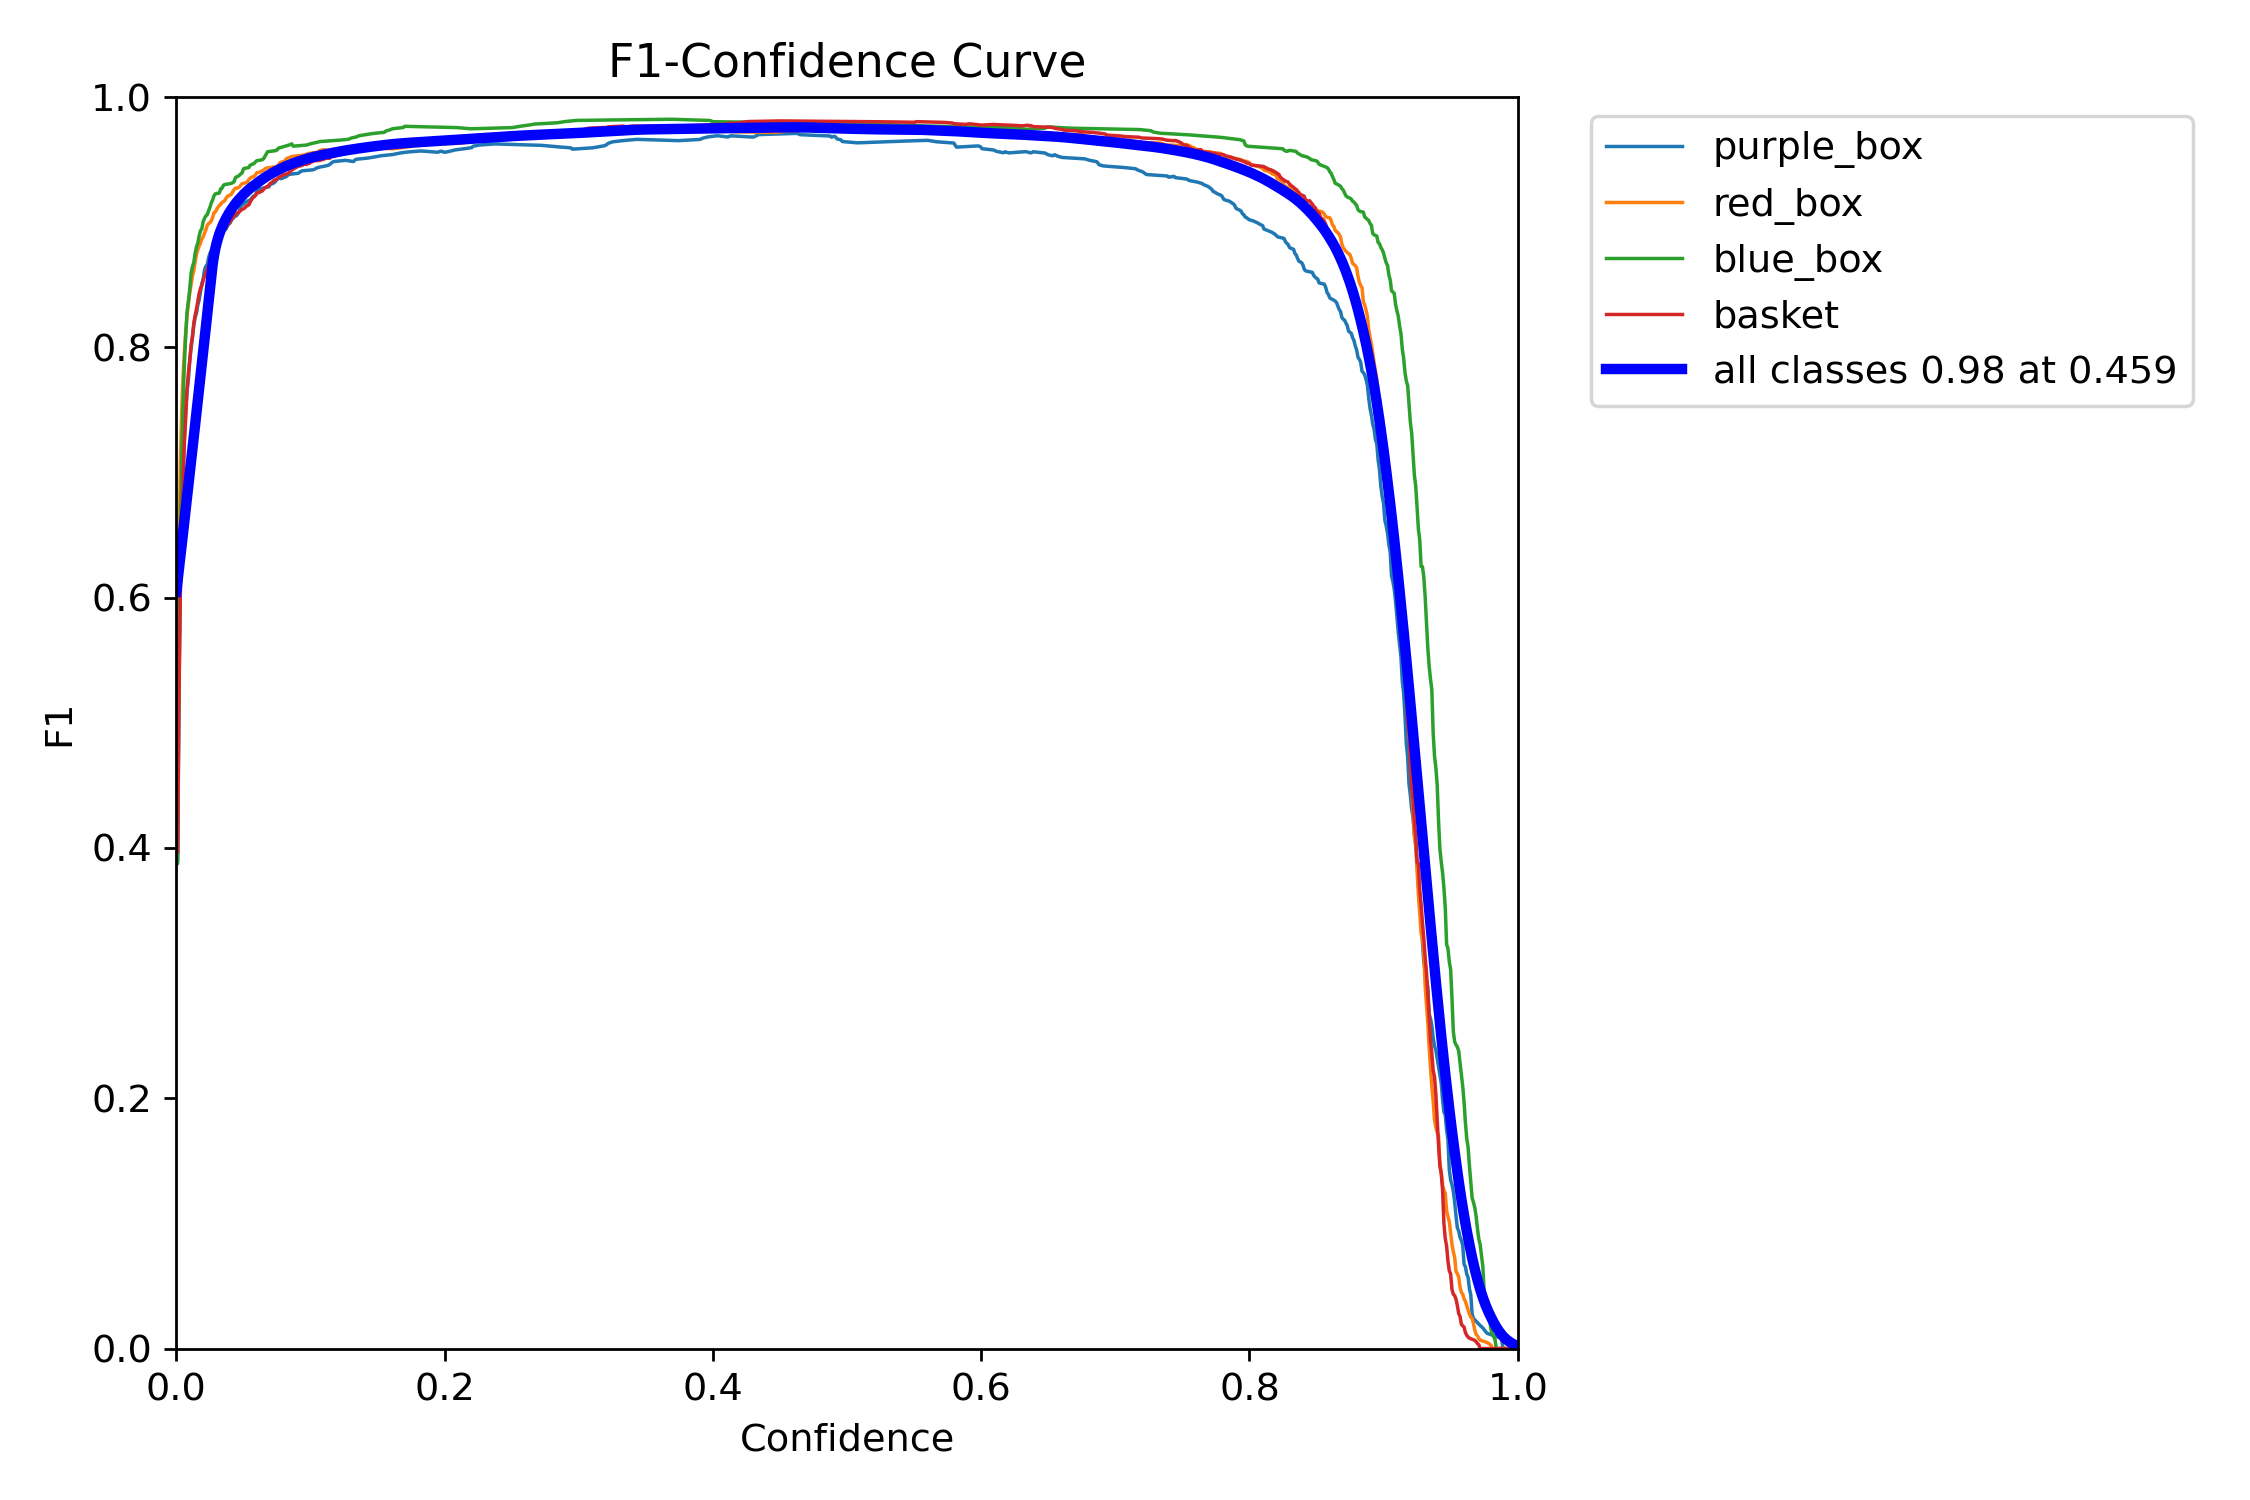
F1分数
$F1=2* 精确率+召回率}$;
F1分数是精确率(Precision)和召回率(Recall)的调和平均值,它同时考虑了模型预测的准确性和覆盖面。F1分数的范围从0到1,其中1表示模型的精确率和召回率都是完美的,而0则表示模型的精确率或召回率至少有一个非常差;
**all classes 0.77 at 0.494 **表示当confidence为0.459时,all classes的F1分数为0.98(最高);表示该模型在0.459的置信度预测类时整体表现良好 。
为什么这个曲线的趋势是这样的?
置信度表示当前预测框内存在这种种类目标的概率,当置信度低时,代表预测框里非常可能不是这种目标,那么精确率就趋于0;当置信度高时,就对画面中的目标要求就很高,被认定为是这种类别就需要很大的概率值,对应覆盖率就趋于0。根据F1的计算公式,那么曲线就该是这种趋势。
我们如何通过F1-Confindence图判断模型的性能?
首先,因为F1分数体现模型同时兼顾准确性和覆盖性的性能,越接近1越好。那么我们希望模型在各置信度区间都能保留这样优良的性能(置信度趋近于0和1时F1分数趋近于0是必然的),因此我们希望在置信度接近0和1的小区间内曲线斜率越大越好,并且曲线在其他区间尽可能接近1。(对于任意类别来说)
F1分数的重要性:
在评价模型时,准确率可能会因为数据的不平衡而变得具有误导性,而F1-Score正好可以弥补这一缺陷。特别对于那些假负或假正都同样不受欢迎的领域,如医疗诊断、欺诈检测等,F1-Score能够更加精准地反映模型的实际表现。
Precision-Confidence Curve
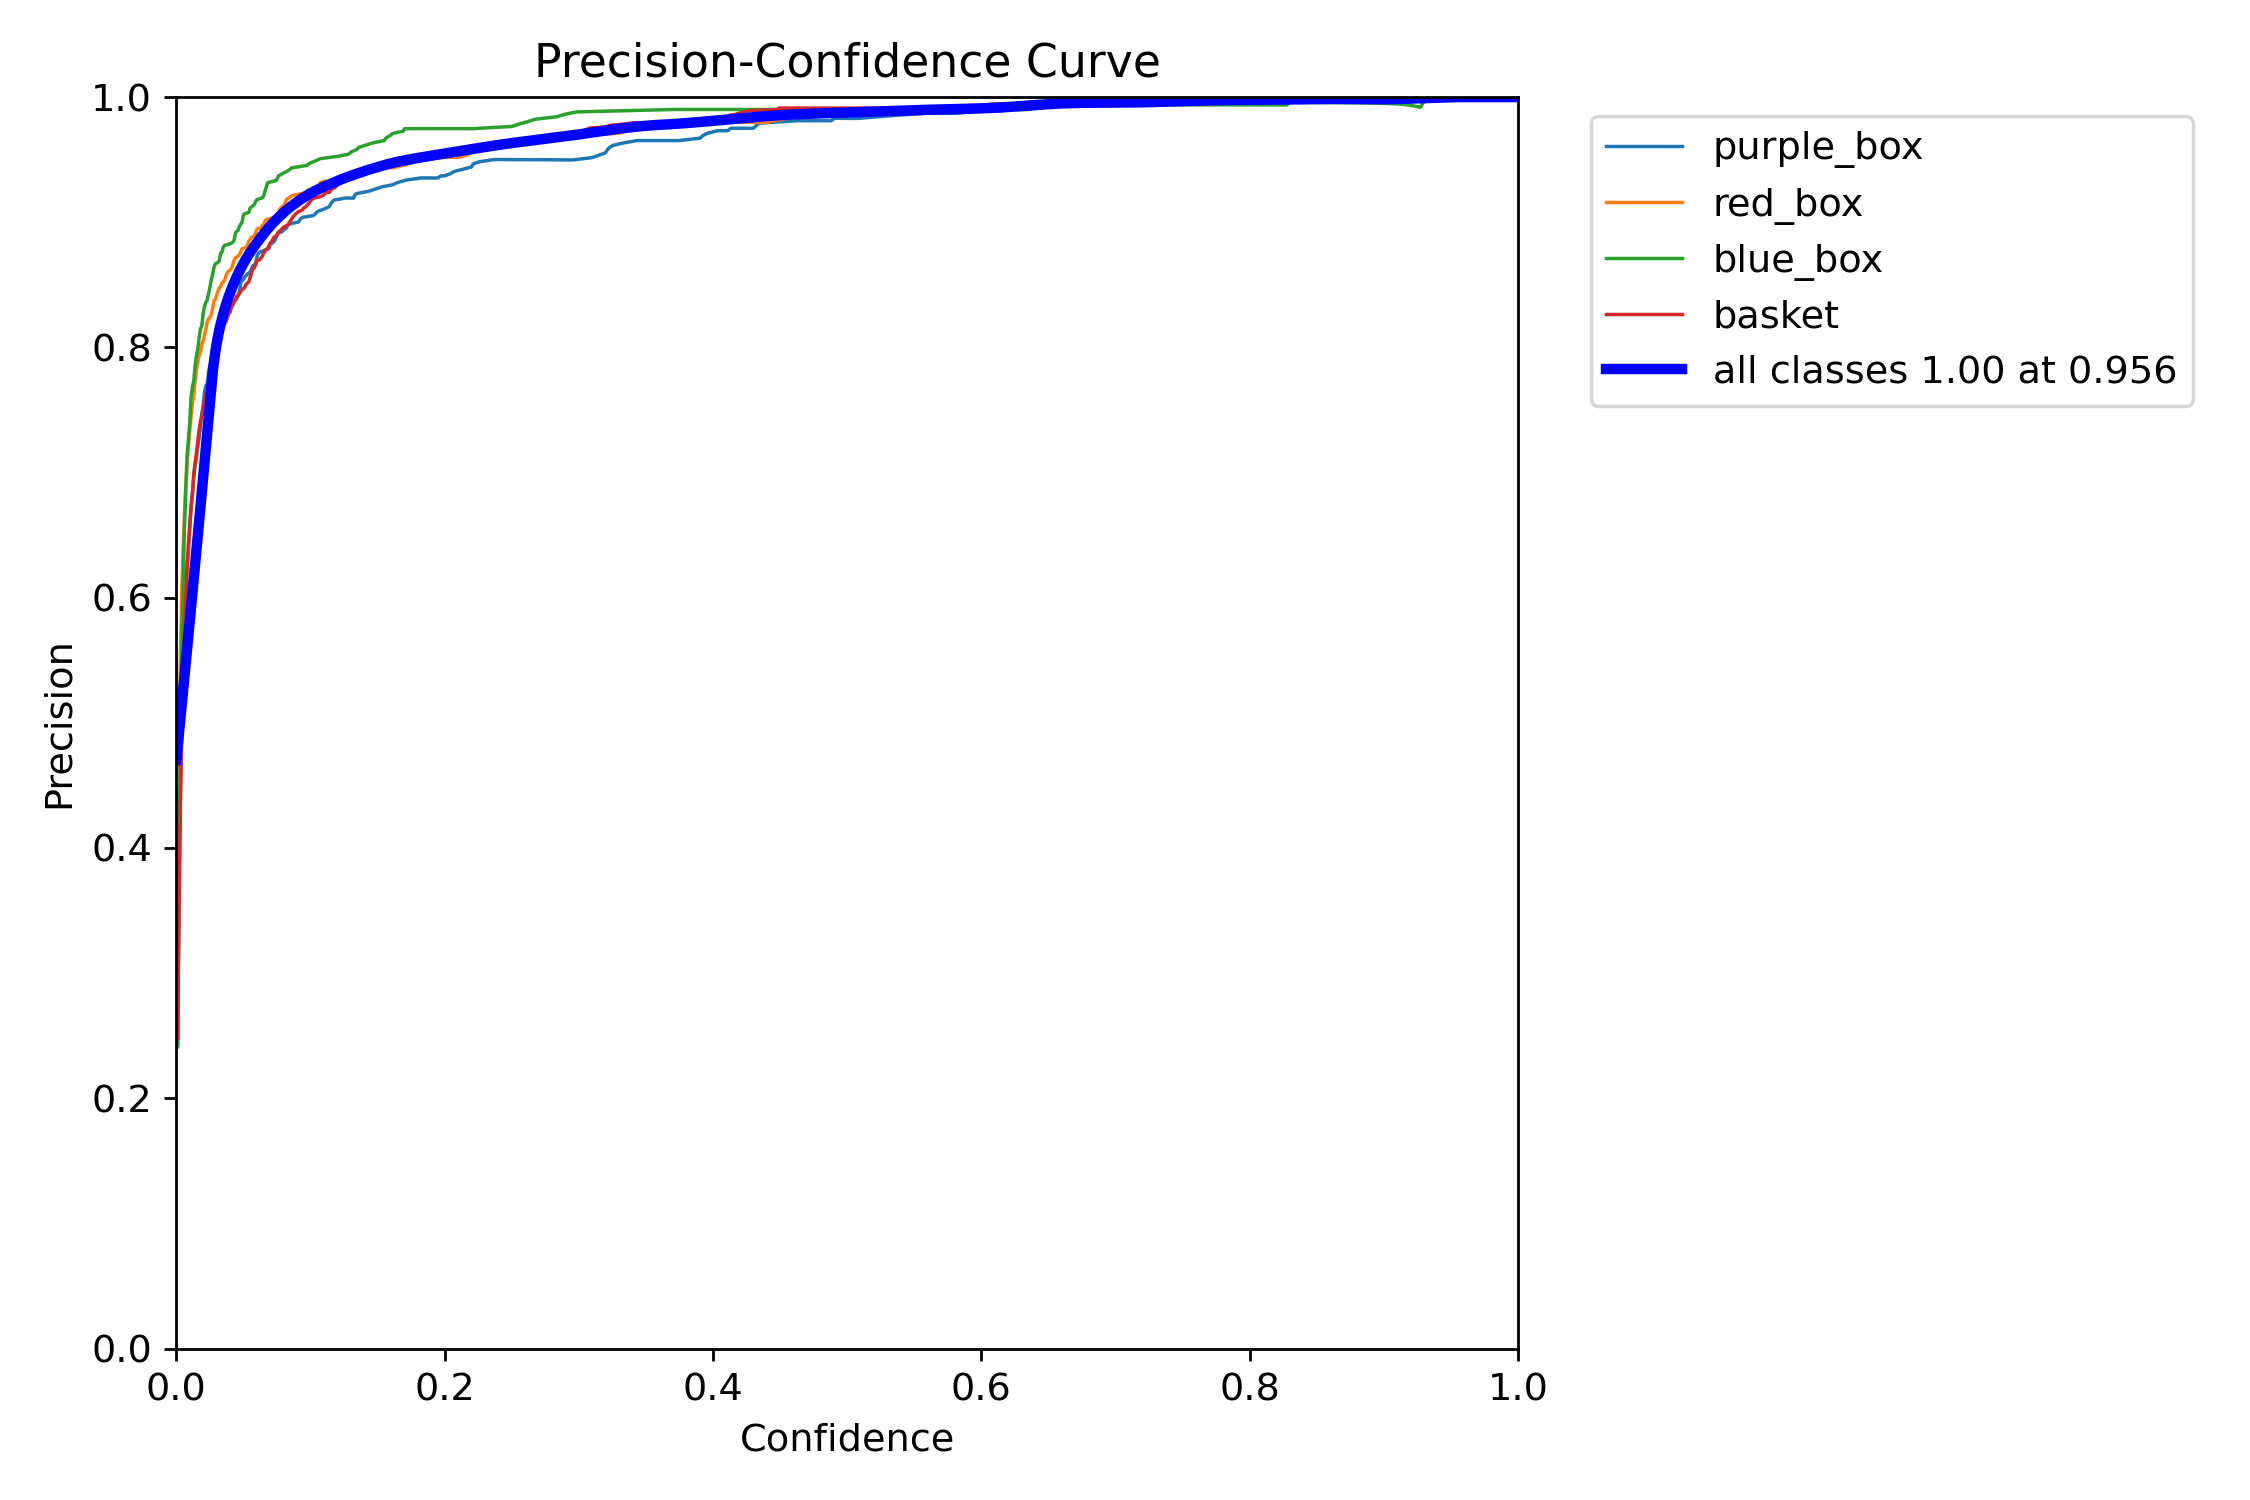
精确率曲线
表达不同类别的精确率随置信度的变化,一般随置信度上升精确度随之上升;
每条曲线右下侧面积越大,该类别的精准率越好。
all classes 1.00 at 0.956 表示所有类别当置信度到达0.956时平均准确率达到1,但是如果模型推理时将置信度设为0.956,那么使用效果在覆盖率上肯定是非常不好的;
通过这些曲线(但也要结合其他图像),可以选择合适的置信度阈值用于模型推理,以过滤掉一些不精确的目标,优化模型的检测结果;
Recall-Confidence Curve
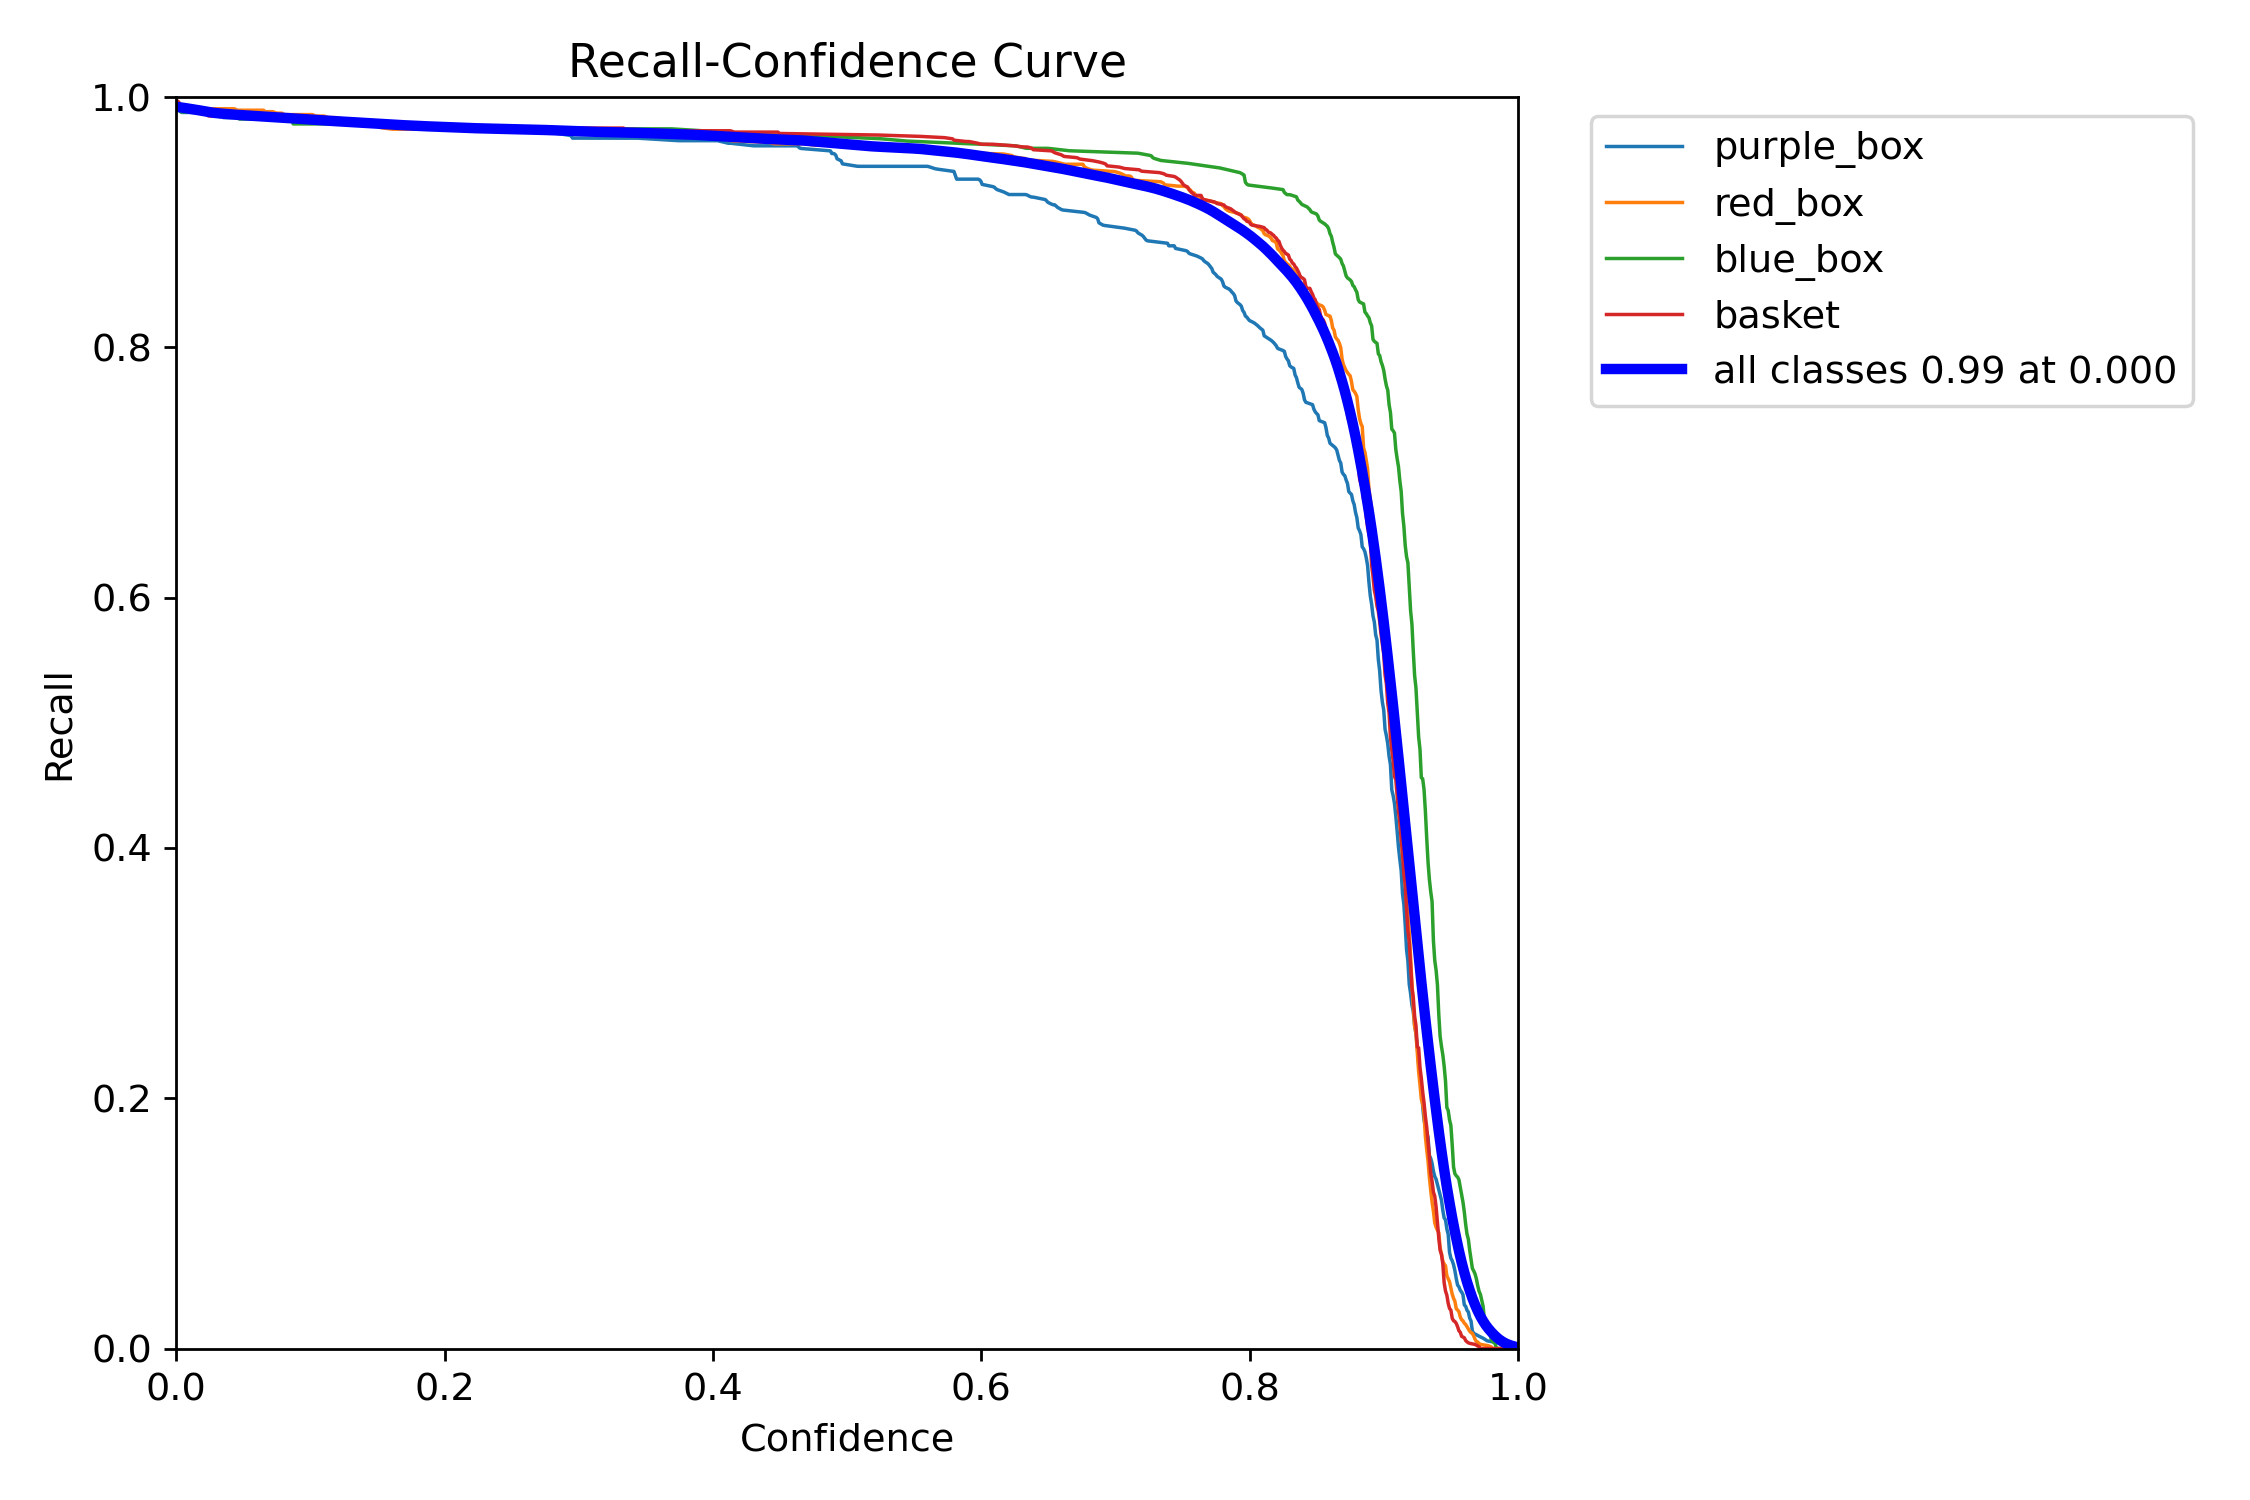
召回率曲线
该曲线表征各类别的召回率和置信度之间的关系,一般随置信度的上升召回率随之下降;
每条曲线左下侧面积越大,代表该类别召回率越好。
all classes 0.99 at 0.000 表示在置信度为0时,平均召回率达到0.99(对于本图就是平均召回率没有大于0.85的位置,其实这个模型在覆盖率上性能不好),如果按照给出的置信度做模型推理,模型的精确率肯定不好;
通过这些曲线(但也结合其他图像),可以选择合适的置信度阈值用于模型推理,提升模型对同类目标检测的覆盖率,优化模型的检测结果;
置信度过高,就会导致召回率低(图像中出现的目标就可能出现漏识别情况),但是被识别出的目标准确率就会比较高(分类错误概率比较低);
反之... ...;
所以可以综合Precision-Confidence Curve、Recall-Confidence Curve找到一个相对合适的置信度阈值用于模型推理。
此外yolov8在模型推理时默认的置信度阈值为0.25,你可以通过conf参数自行设置。
Precision-Recall Curve
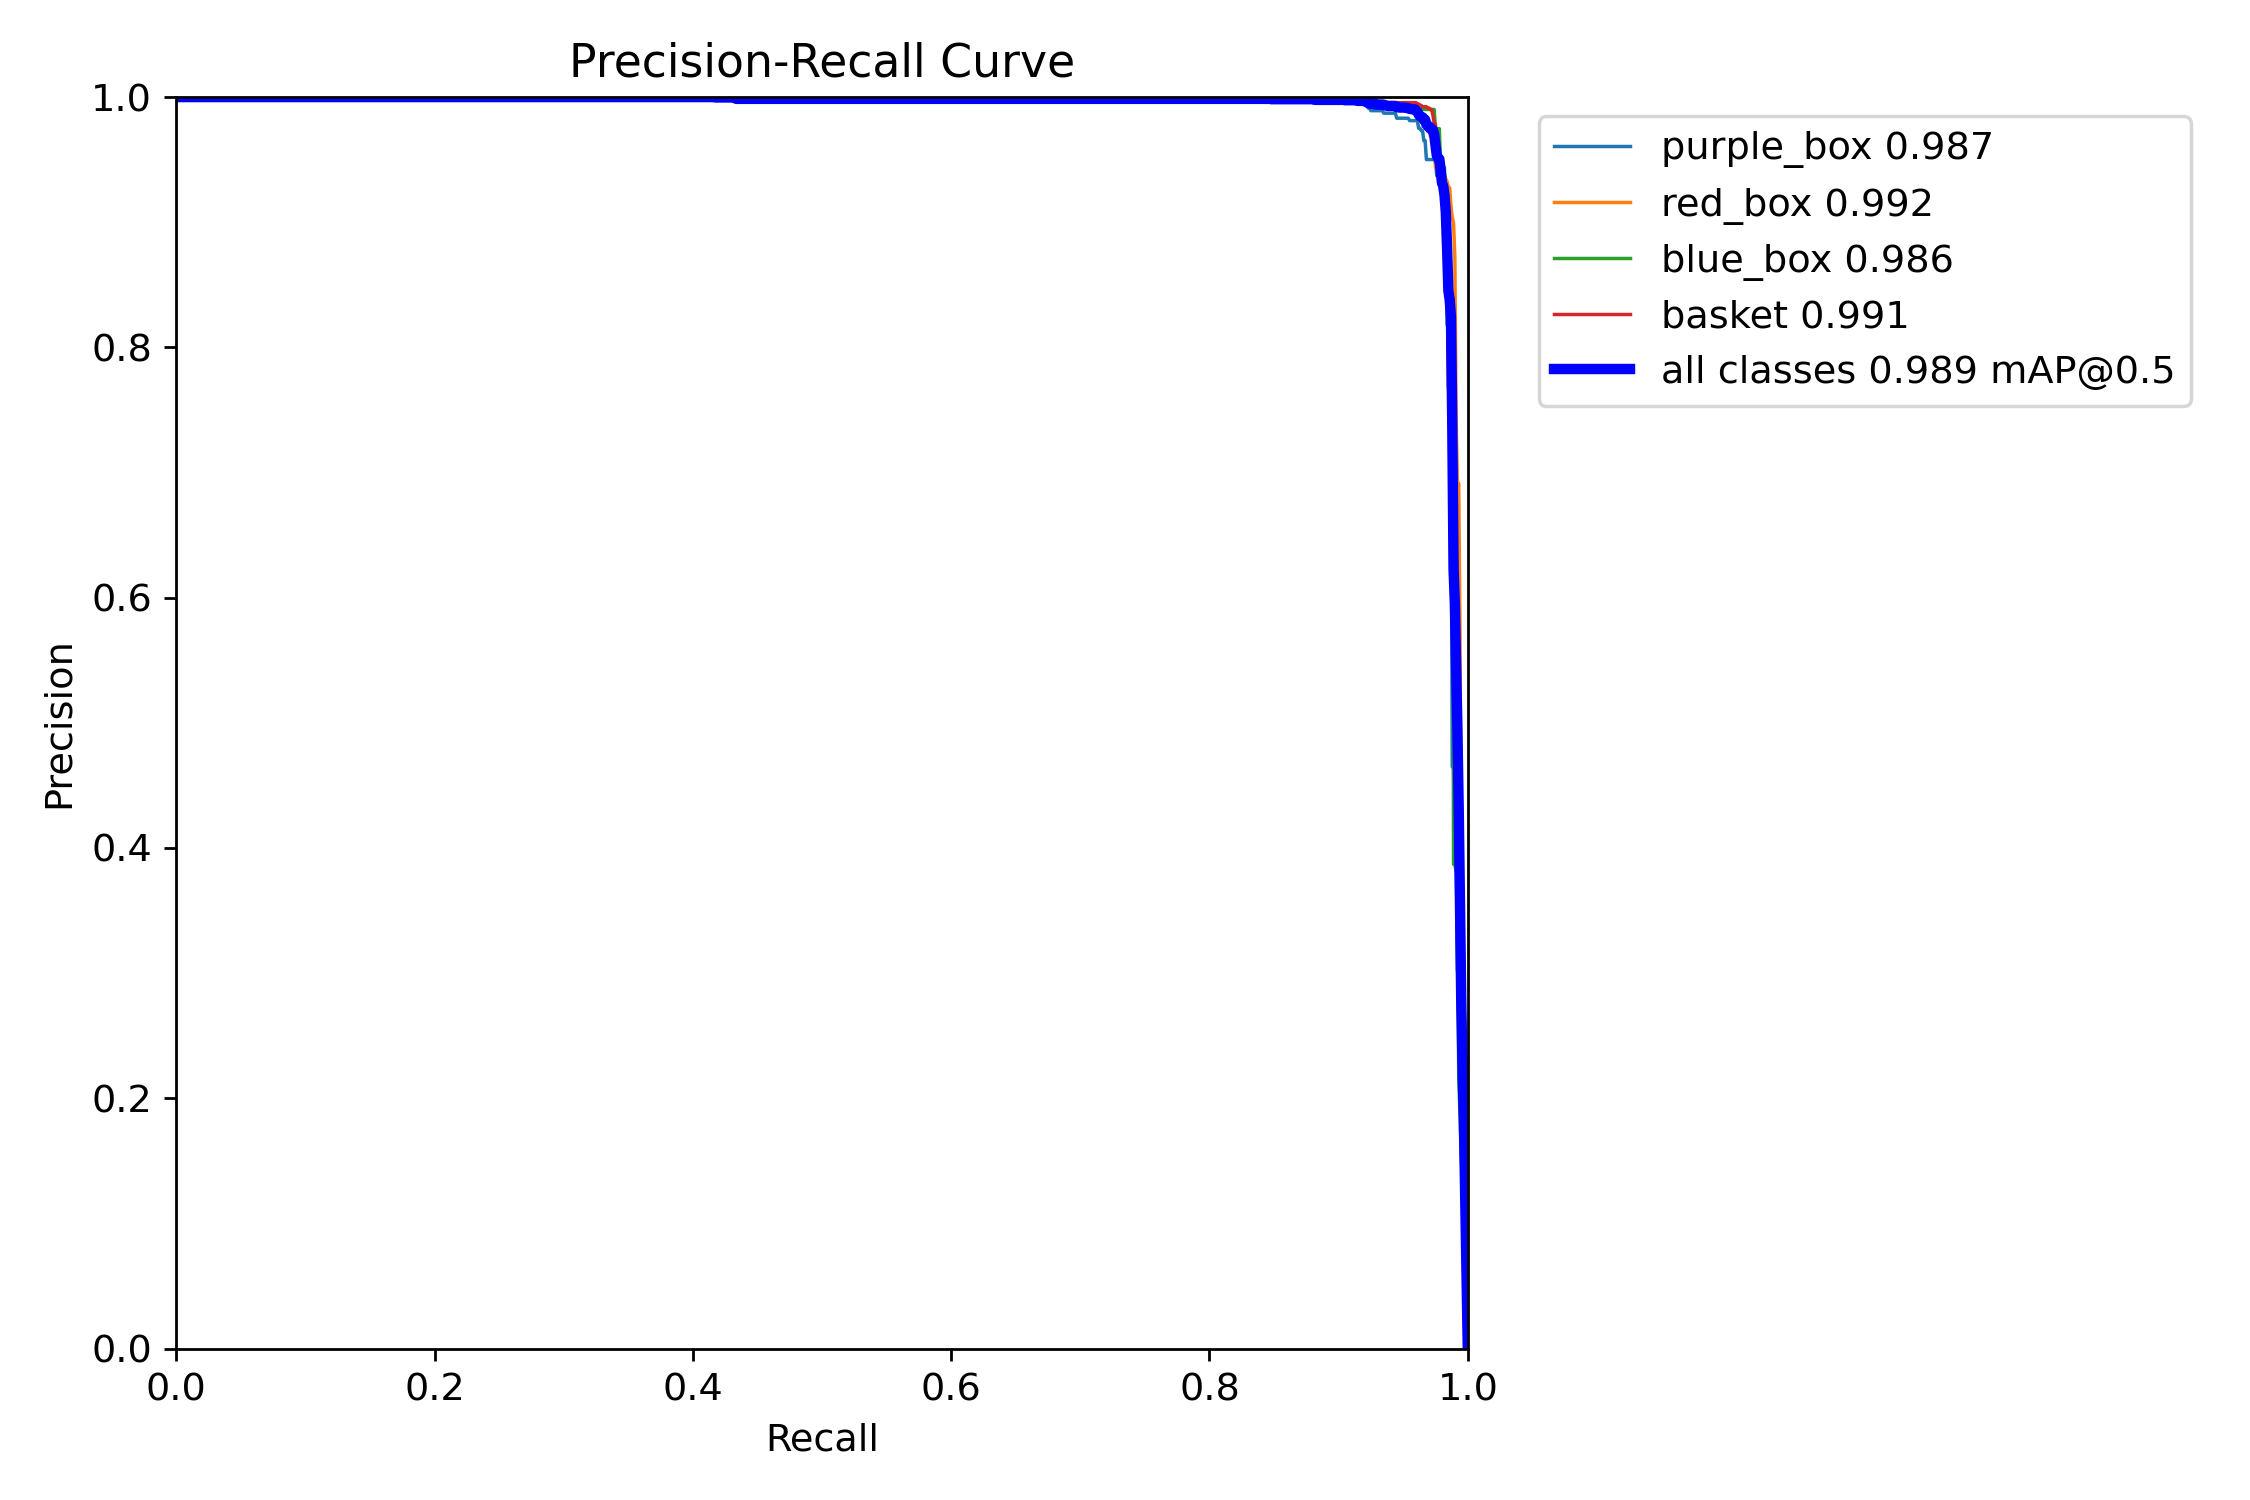
精确度-召回率曲线
该曲线展示了不同阈值下模型的的精准率和召回率,各曲线都显示了随着召回率的增加,精确度略有下降的趋势,反之亦然。
通过这条曲线,可以评估模型在目标检测任务中的整体性能,并找到合适的置信度阈值,以在精确率和召回率之间做出最佳平衡。PR 曲线越接近右上角,模型性能越好,曲线下方的面积越大,说明模型在不同置信度下的表现越稳定。
result.csv
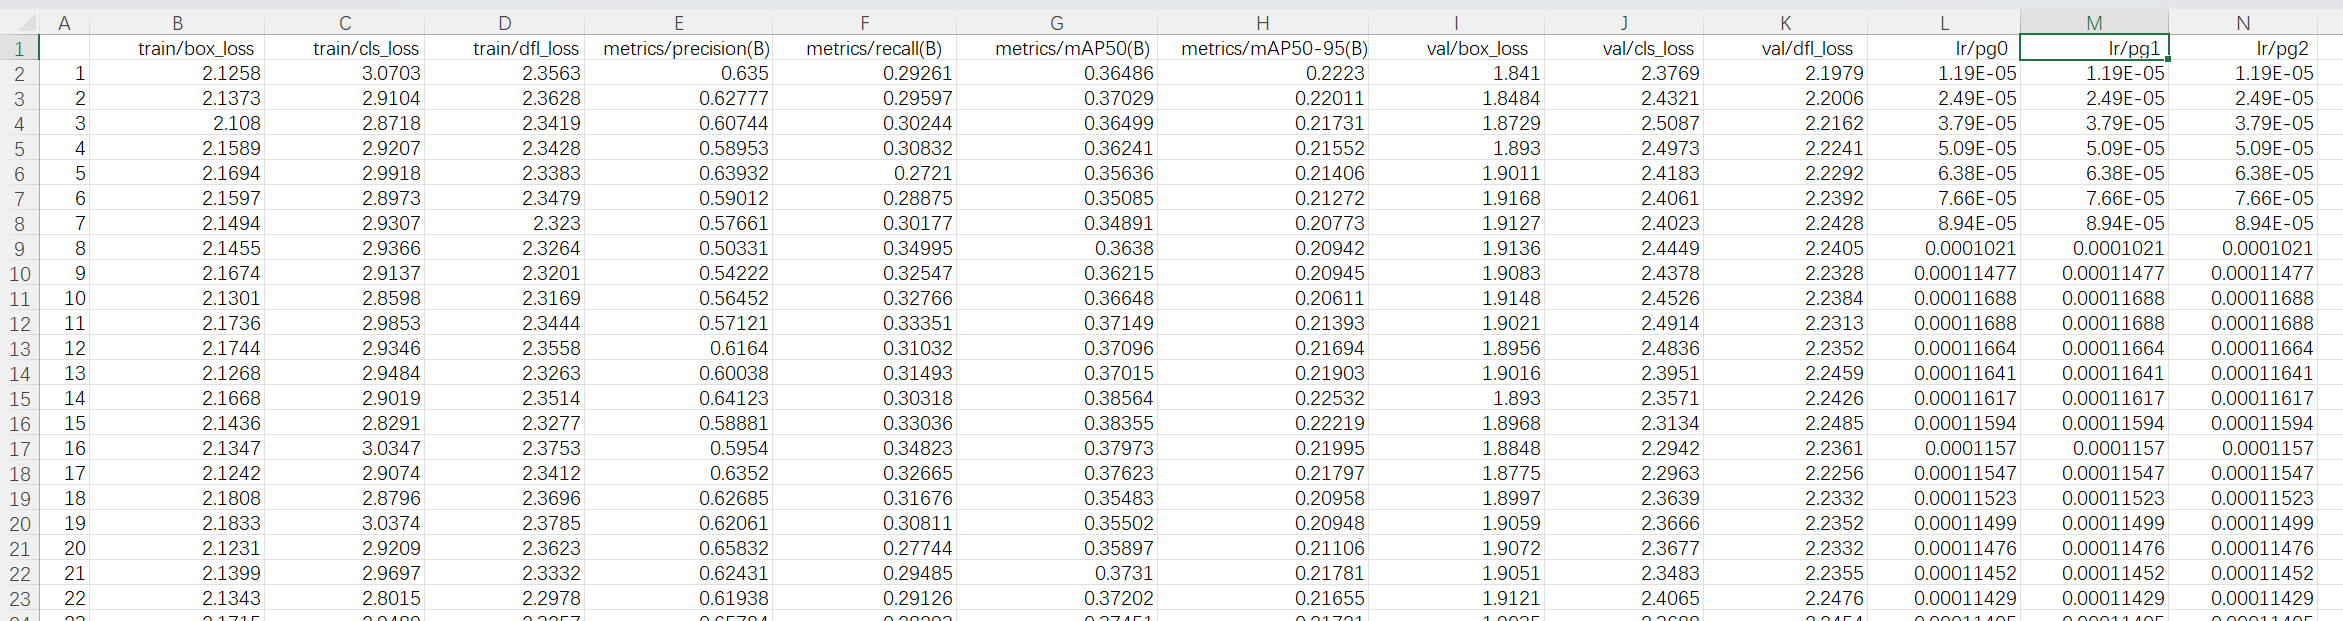
记录了每个训练 epoch 的详细信息,包括每轮训练的指标和结果:
epoch:当前的训练轮次(epoch),即模型训练的迭代次数。
time:训练时间,通常指每个 epoch 的训练所花费的时间。
train/box_loss:训练阶段的边框损失(box loss),衡量预测框与真实框之间的差异。
train/cls_loss:训练阶段的分类损失(class loss),衡量预测类别与真实类别之间的差异。
train/dfl_loss:训练阶段的分布式标签损失(distribution focal loss),用于改善分类和边框回归的性能。
metrics/precision(B):在训练过程中,模型的精确度(precision),B 表示基于边界框的精度计算。
metrics/recall(B):在训练过程中,模型的召回率(recall),B 表示基于边界框的召回计算。
metrics/mAP50(B):在训练过程中,模型在 IOU=0.5 时的平均精度均值(mAP50),B 表示基于边界框的计算。
metrics/mAP50-95(B):在训练过程中,模型在 IOU=0.5 到 0.95 范围内的平均精度均值(mAP50-95),B 表示基于边界框的计算。
val/box_loss:验证阶段的边框损失(box loss),衡量预测框与真实框之间的差异。
val/cls_loss:验证阶段的分类损失(class loss),衡量预测类别与真实类别之间的差异。
val/dfl_loss:验证阶段的分布式标签损失(distribution focal loss)。
其中mAP50和mAP50-90是评价模型检测精度的重要参数:
https://www.bilibili.com/video/BV1vf42127LL?vd_source=2a70e8cbccfb71570f2b97be1853e0df
result.png
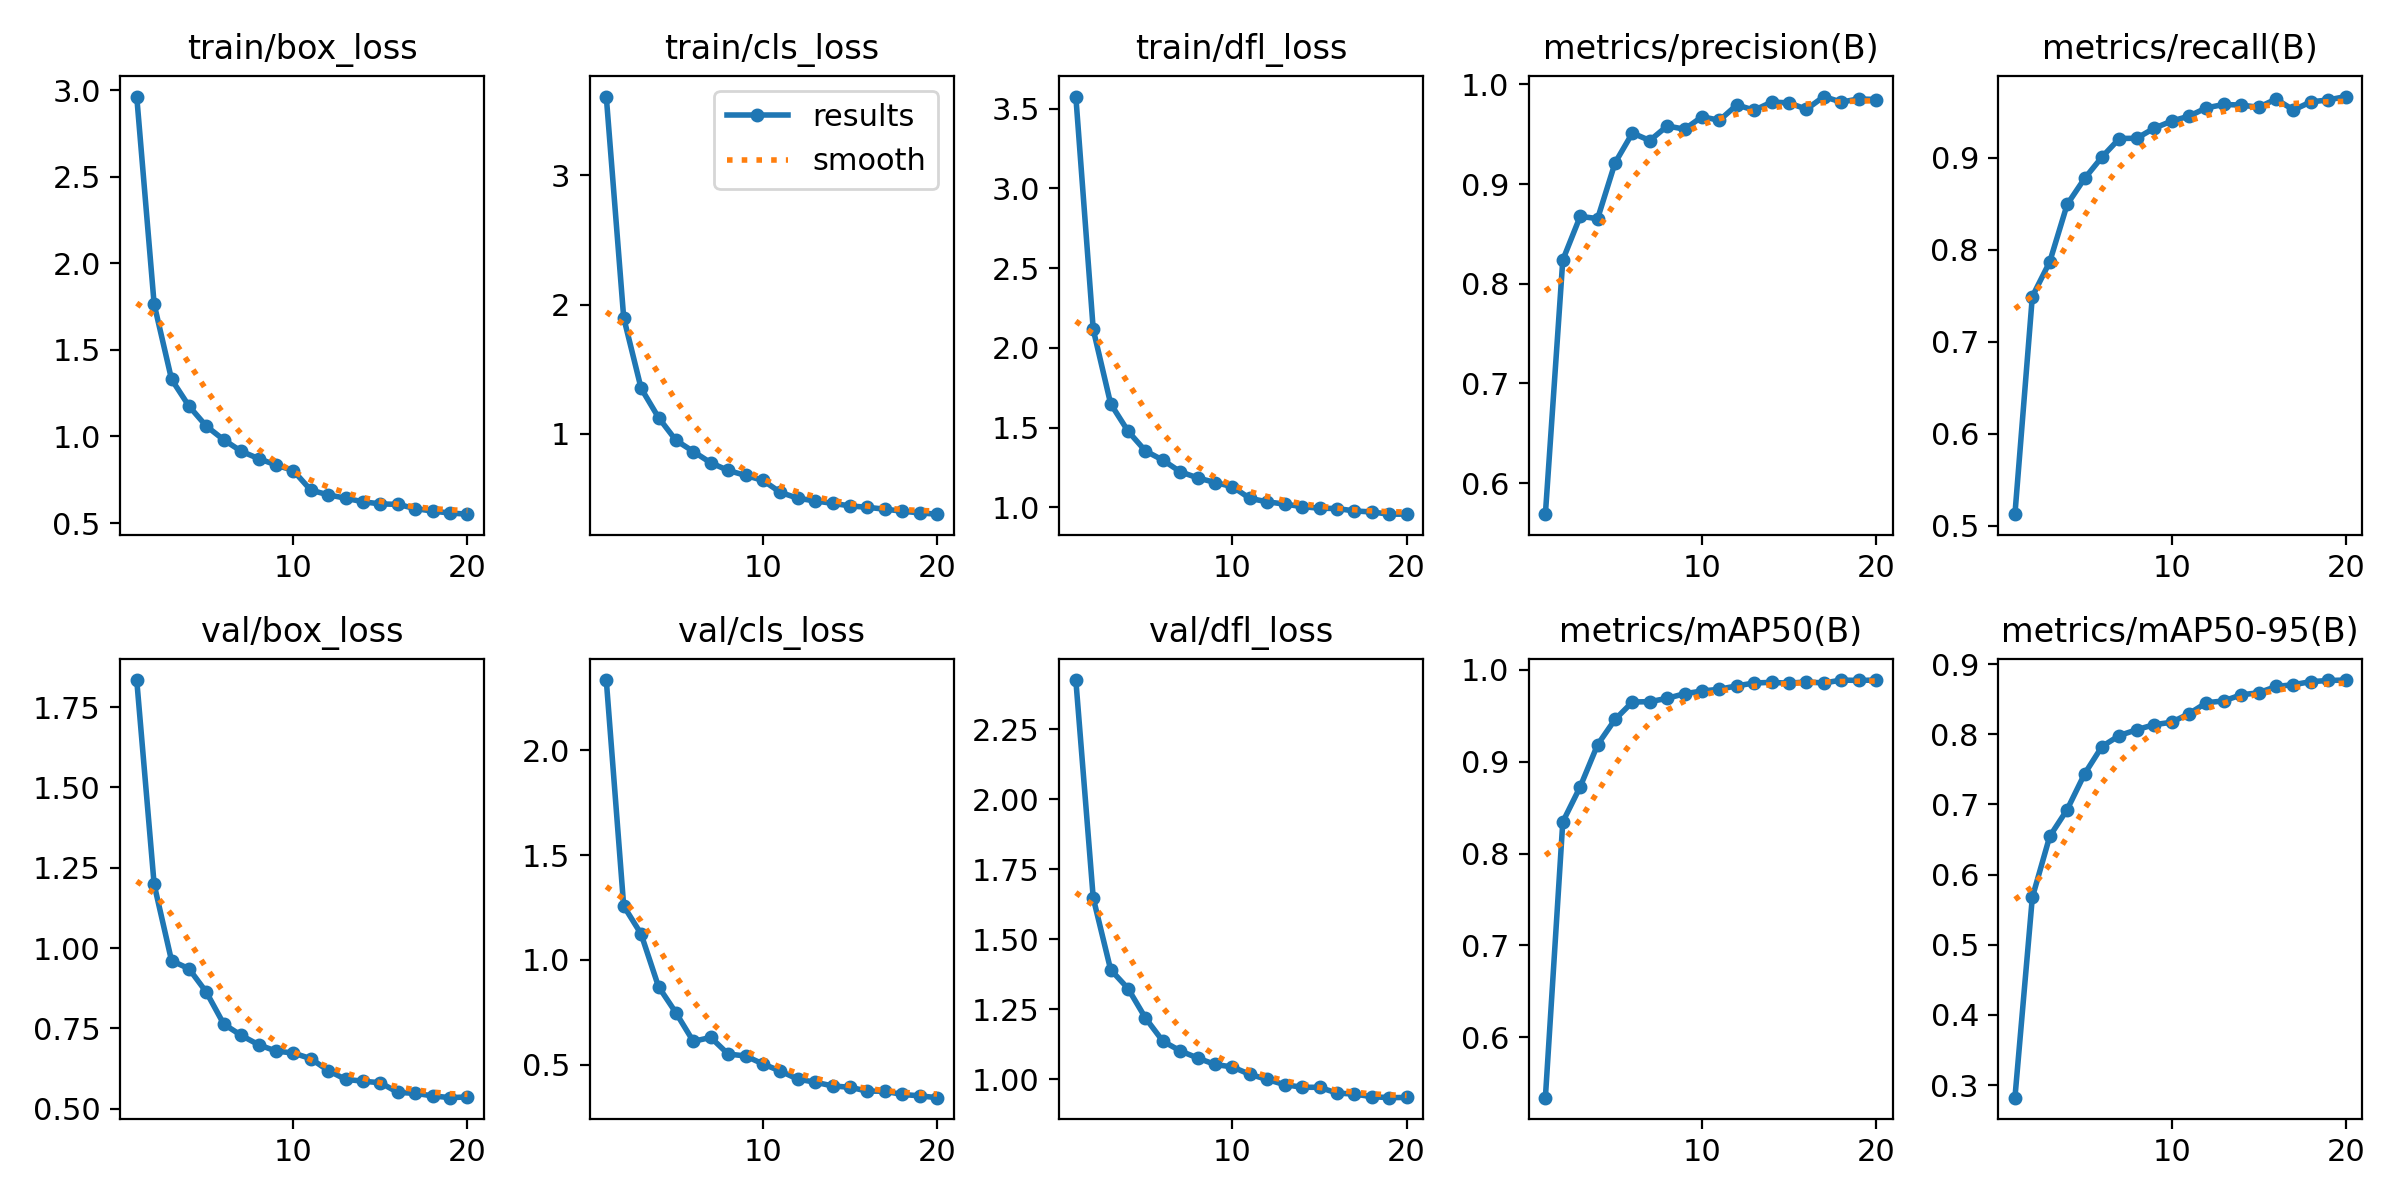
该图像表示随训练轮数epochs的增加,模型的各评价指标的变化。
box_loss:定位损失曲线。
含义:边界框损失,衡量预测的边界框与真实边界框之间的误差。包括边界框的中心位置、宽度、高度等。
图表:通常显示为训练轮次或步数上的损失值曲线,较低的损失值表明模型对边界框的预测更加准确。
cls_loss:分类损失曲线。
含义:类别损失,衡量预测的类别标签与真实类别标签之间的差距。反映了分类器的准确性。
图表:显示为训练轮次或步数上的损失值曲线,较低的损失值表示分类器性能较好。
dfl_loss:目标检测损失曲线。
含义:分布式定位损失(Distribution Focal Loss),处理定位任务中的类别不平衡问题。帮助模型更加关注难以预测的目标。
图表:显示为训练轮次或步数上的损失值曲线,较低的损失值表示分布式定位任务的效果较好。
什么是dfl(分布式定位损失)?
分布式定位损失(Distribution Focal Loss, DFL)是一种用于物体检测任务的损失函数,旨在改进目标检测模型的定位精度。DFL_loss被用于计算预测框与真实框之间的差异,帮助模型更准确地定位目标对象。DFL_loss通过以概率的方式对预测框进行回归,并使用交叉熵损失函数来计算损失,从而优化模型性能。
简单来说,DFL_loss是一种针对目标检测任务中边界框回归问题的优化策略,旨在提高模型在目标位置预测上的准确性。
train_batchX.jpg
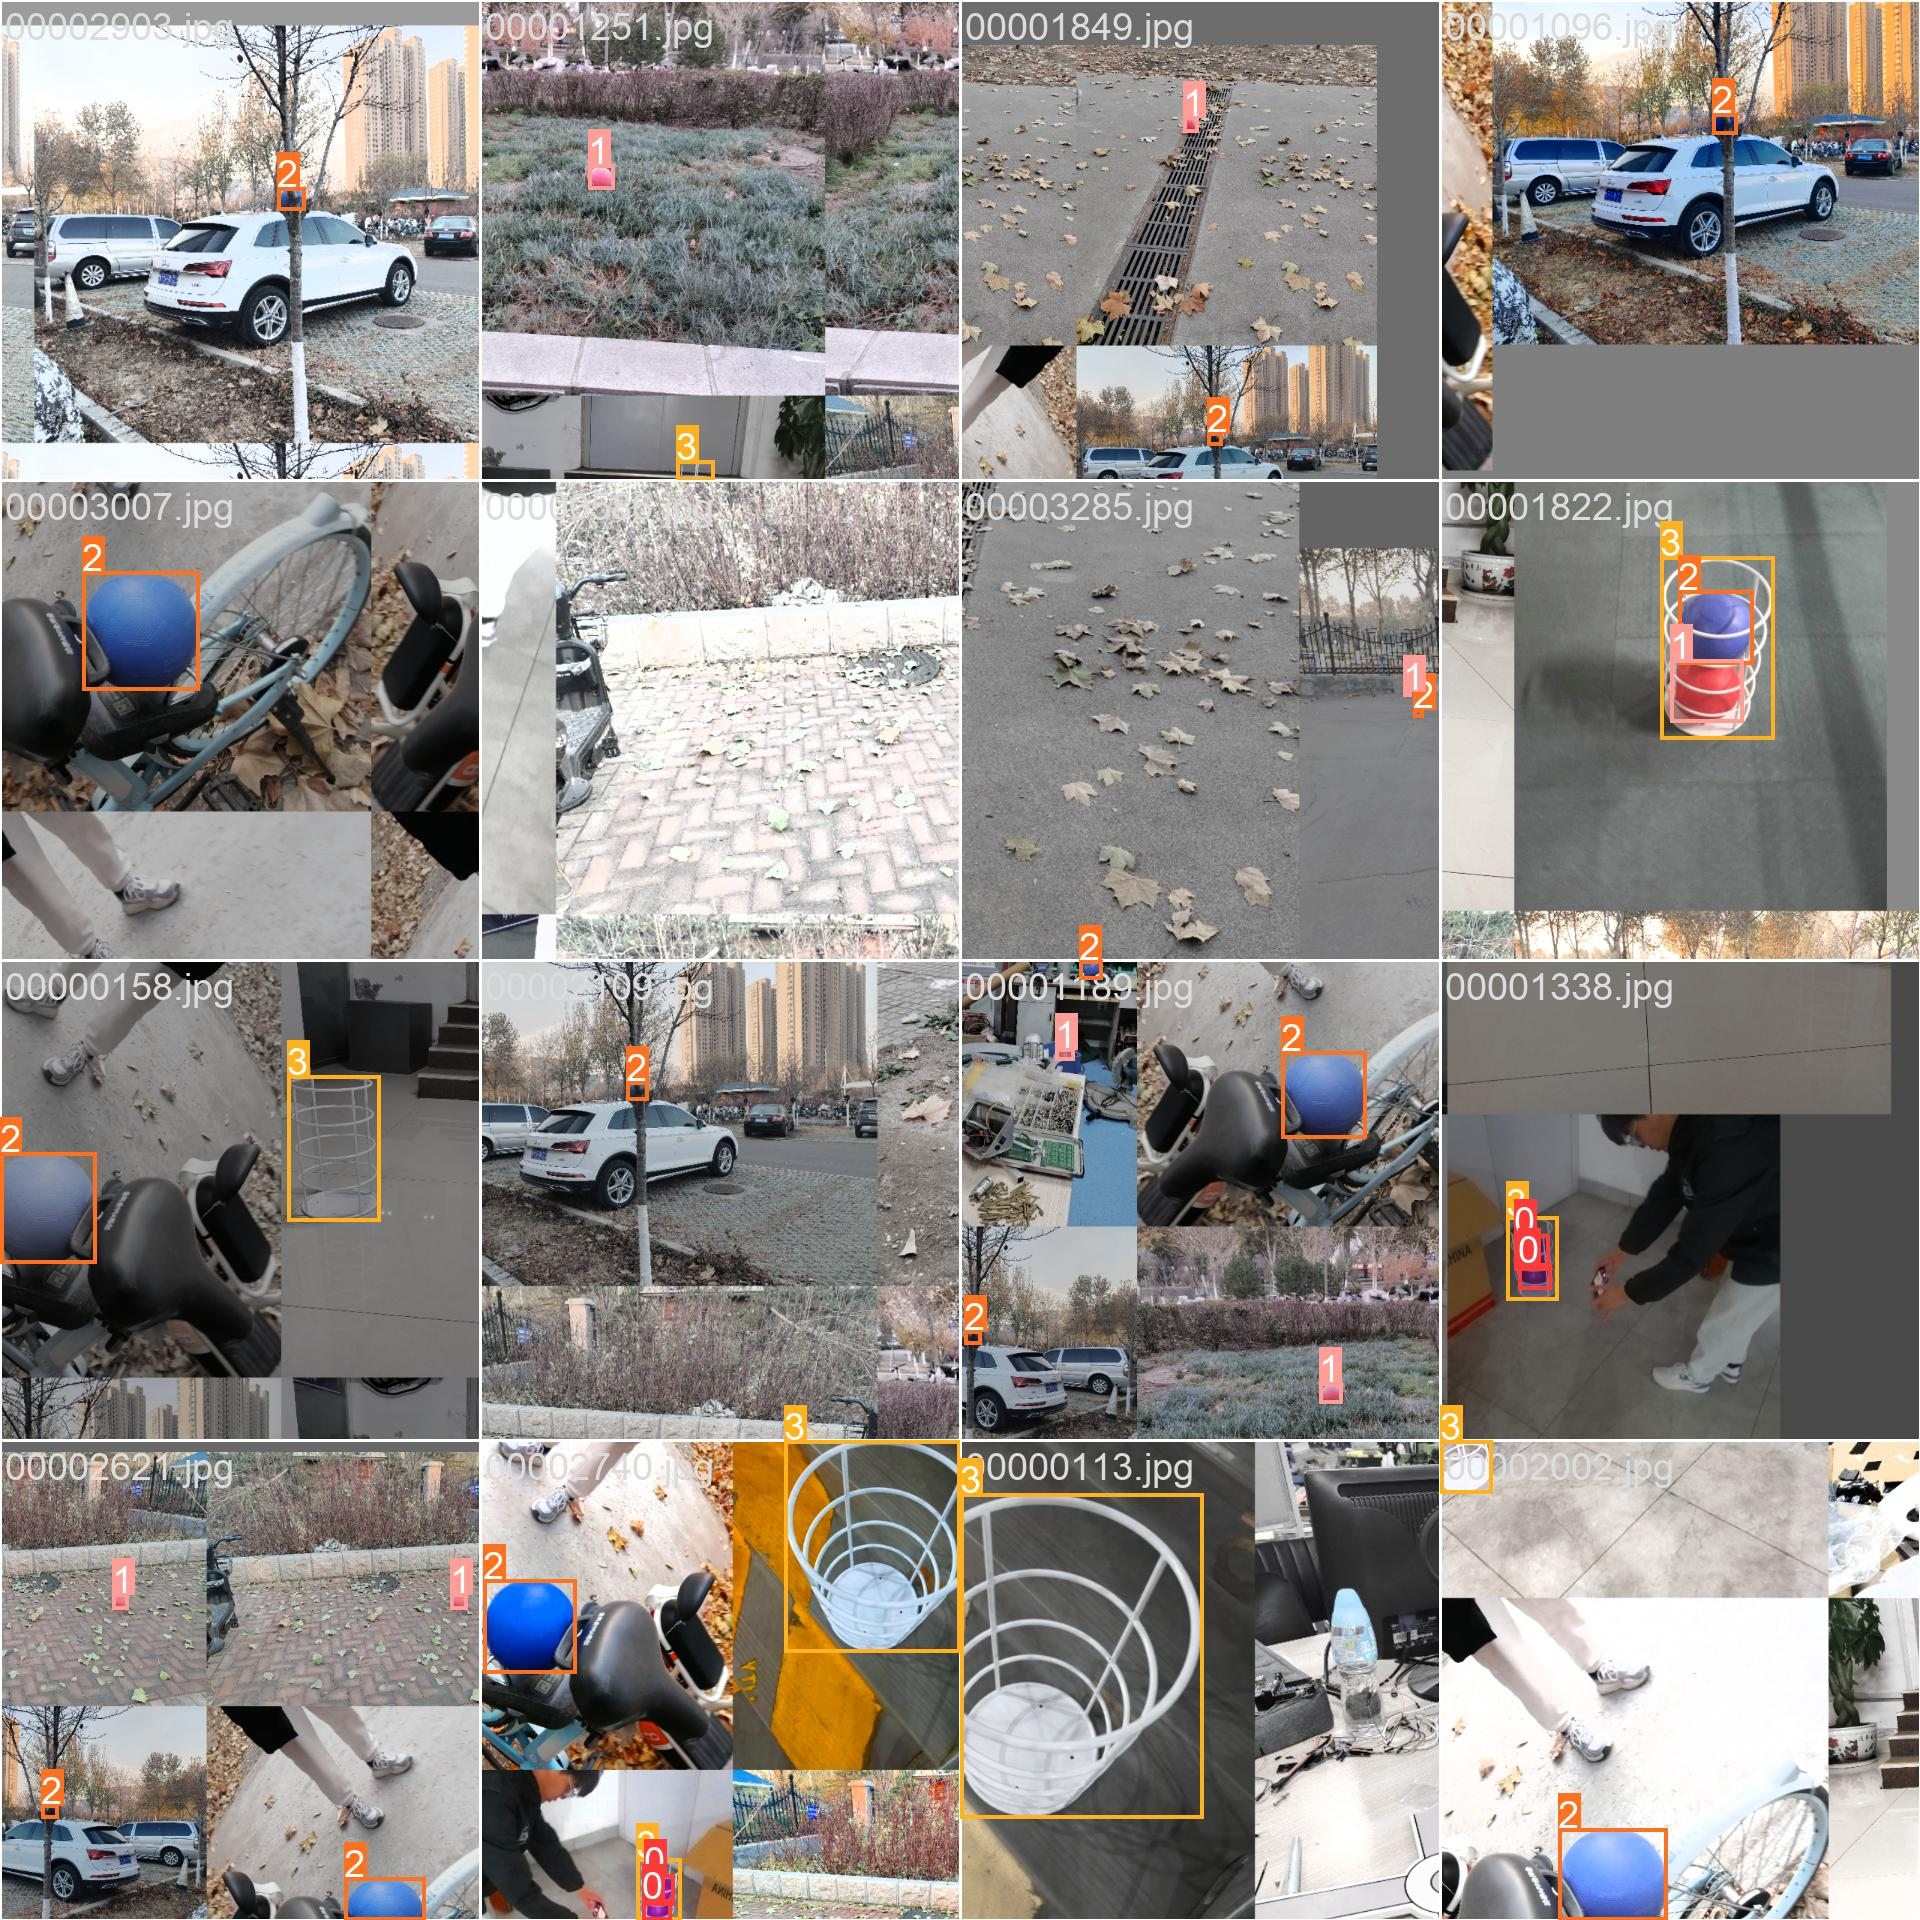
这些图像文件,显示了在训练过程中对某些批次(batch)的图像进行检测后的结果,通常用于展示训练中预测的效果。
val_batchX_labels.jpg && val_batchX_pred.jpg
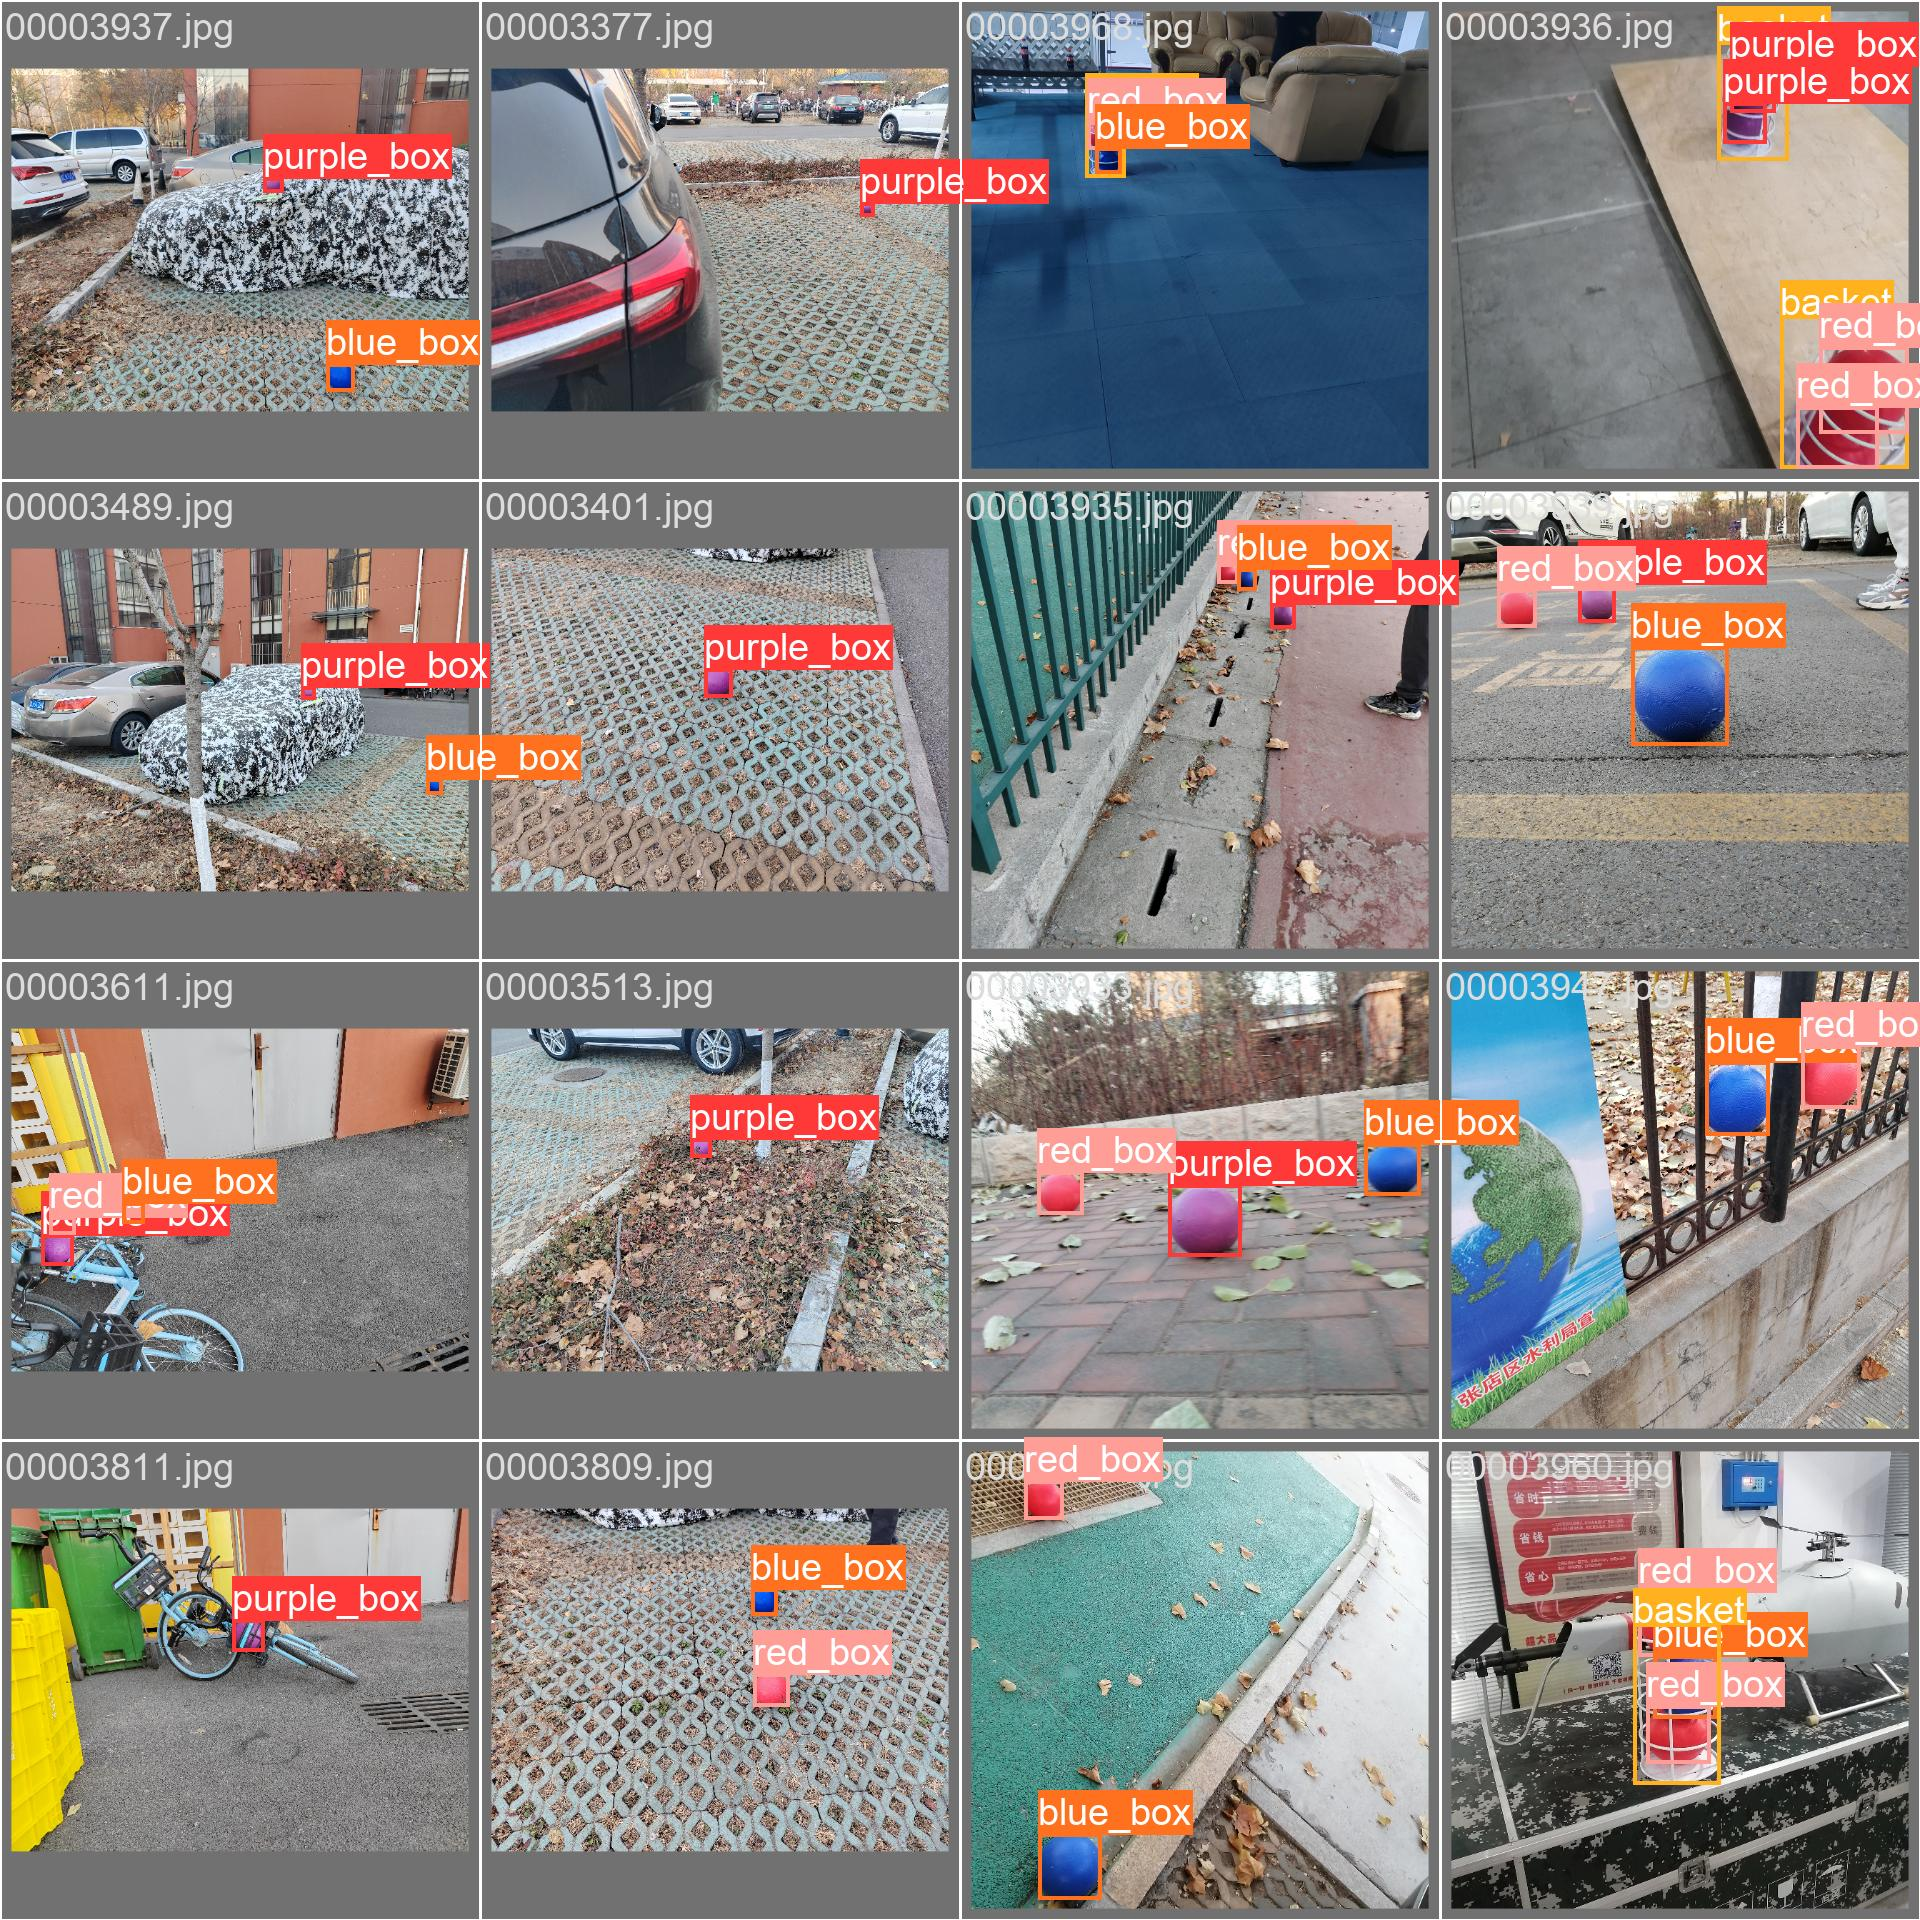
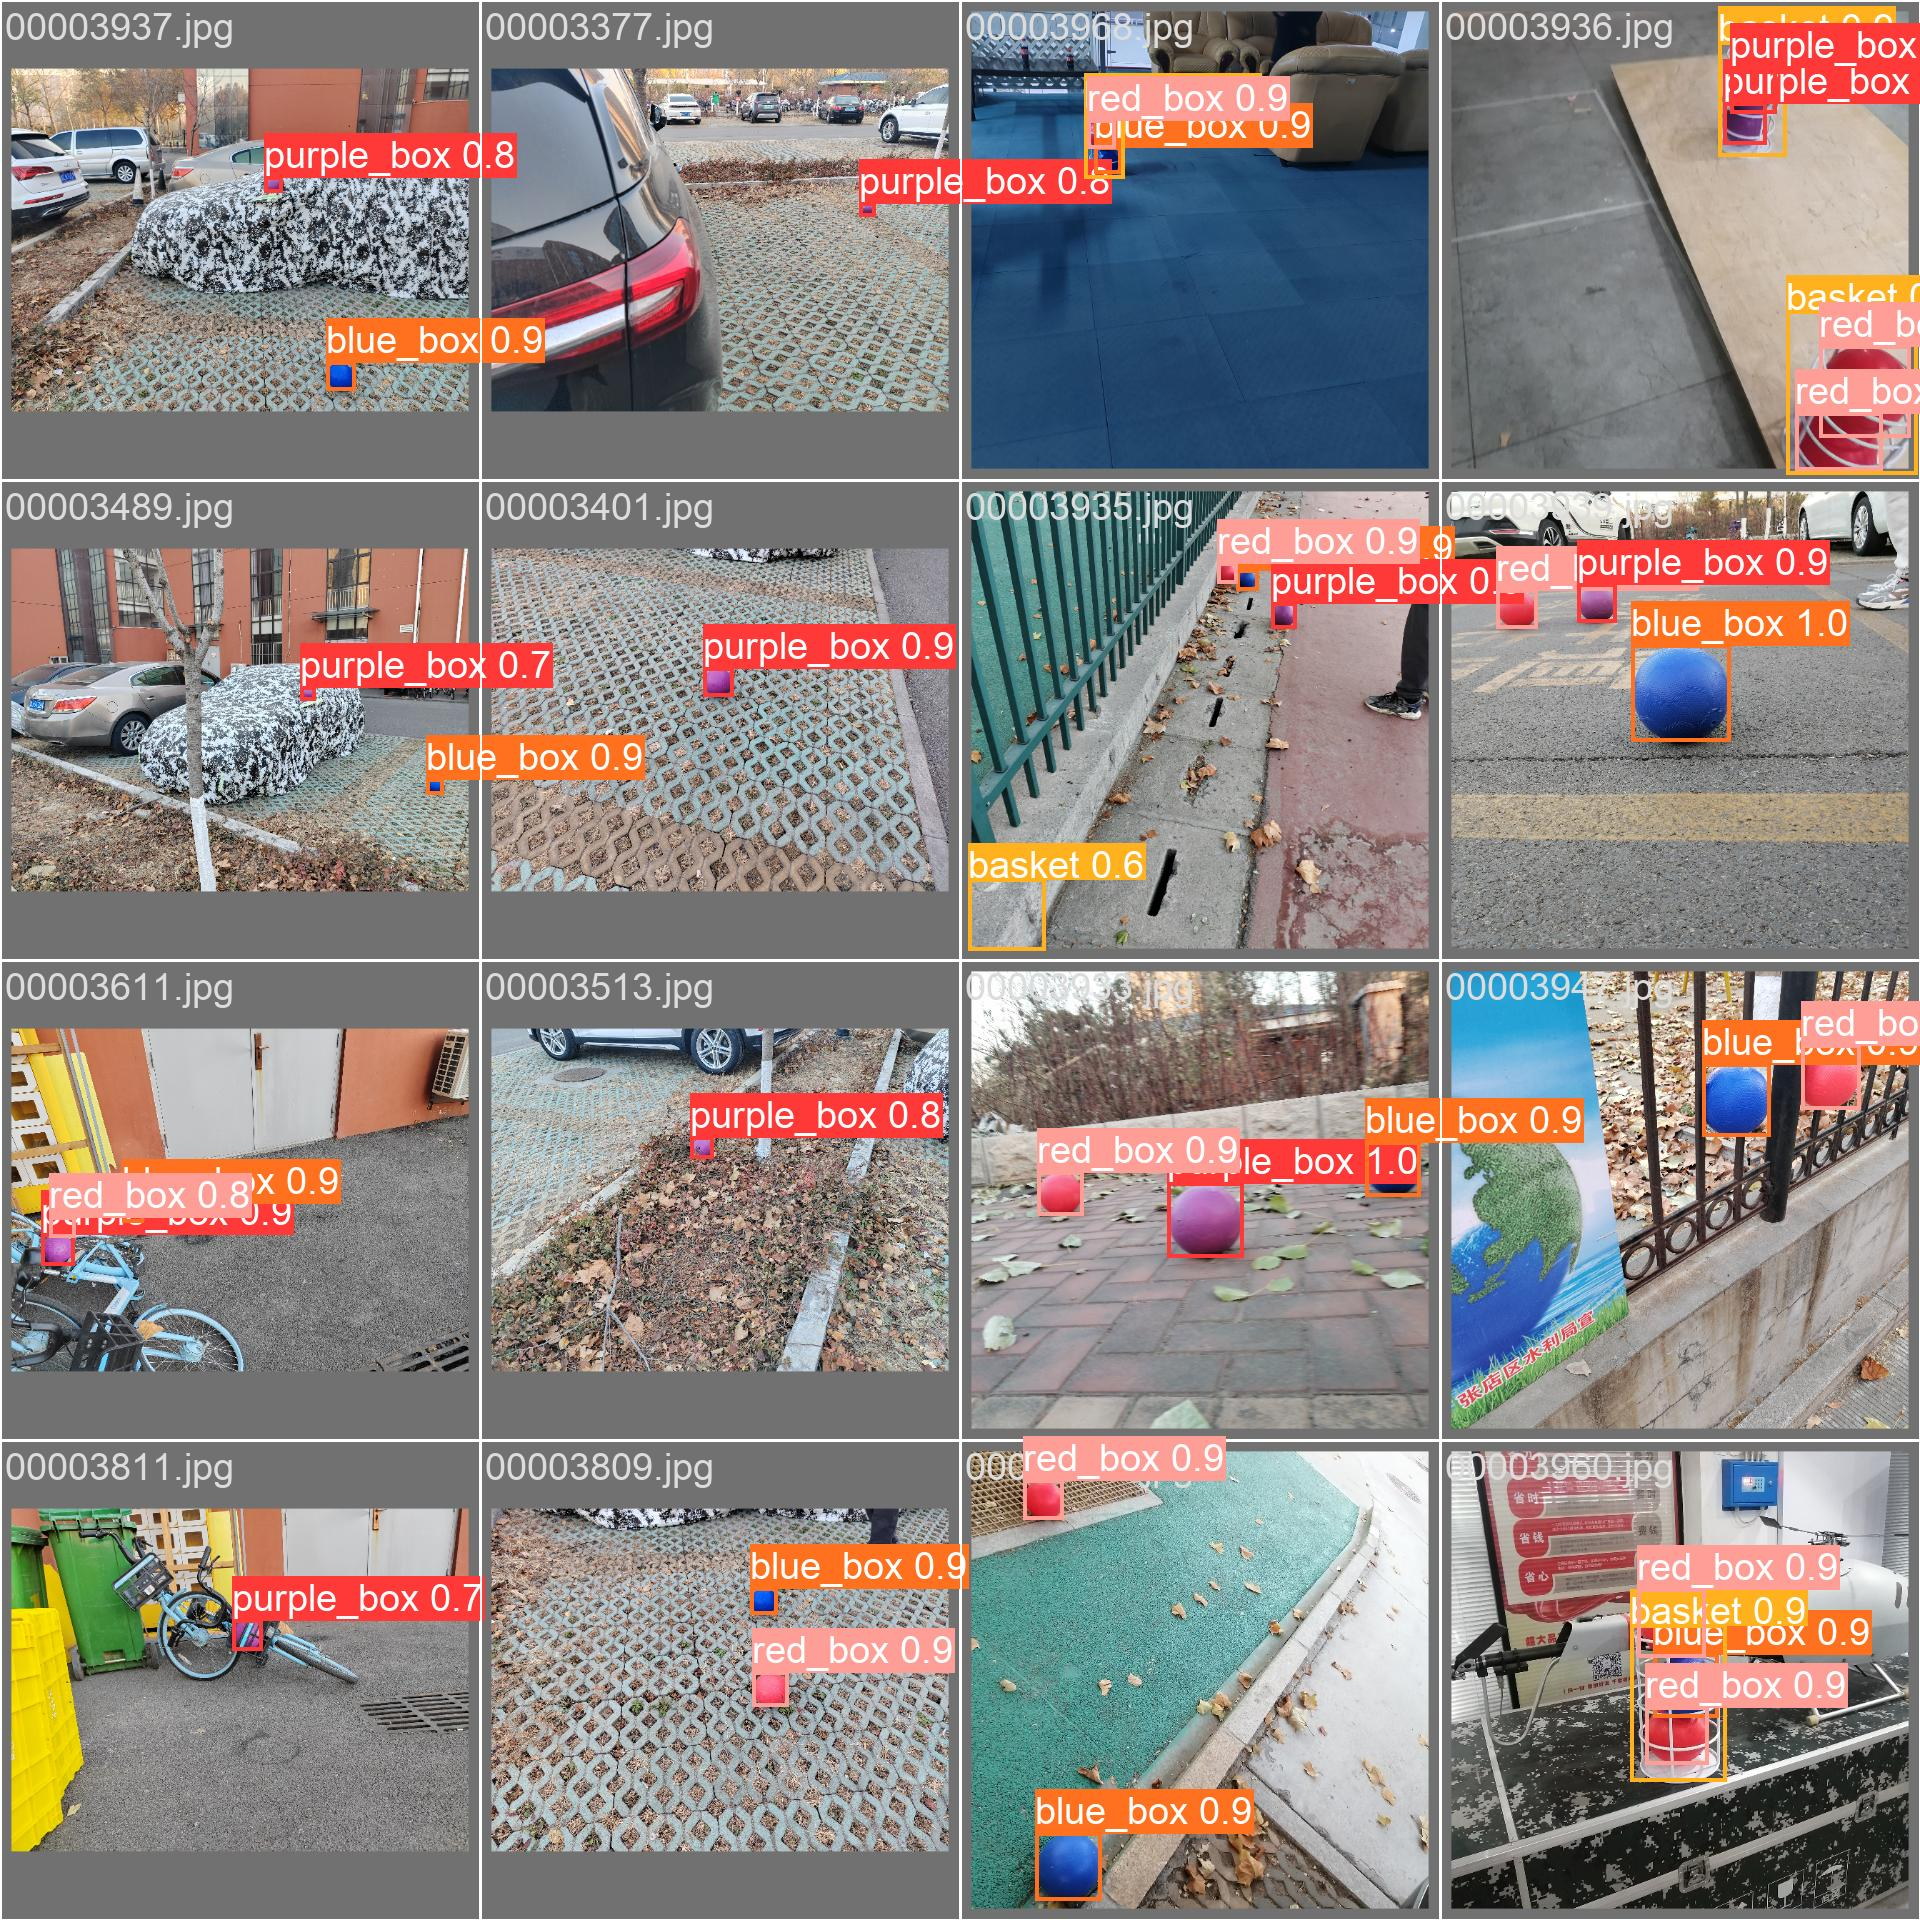
验证集真实标注的图像标签和模型训练时验证阶段预测标签对比,以观察模型在验证集上的表现。
二、数据集评价指
label.png
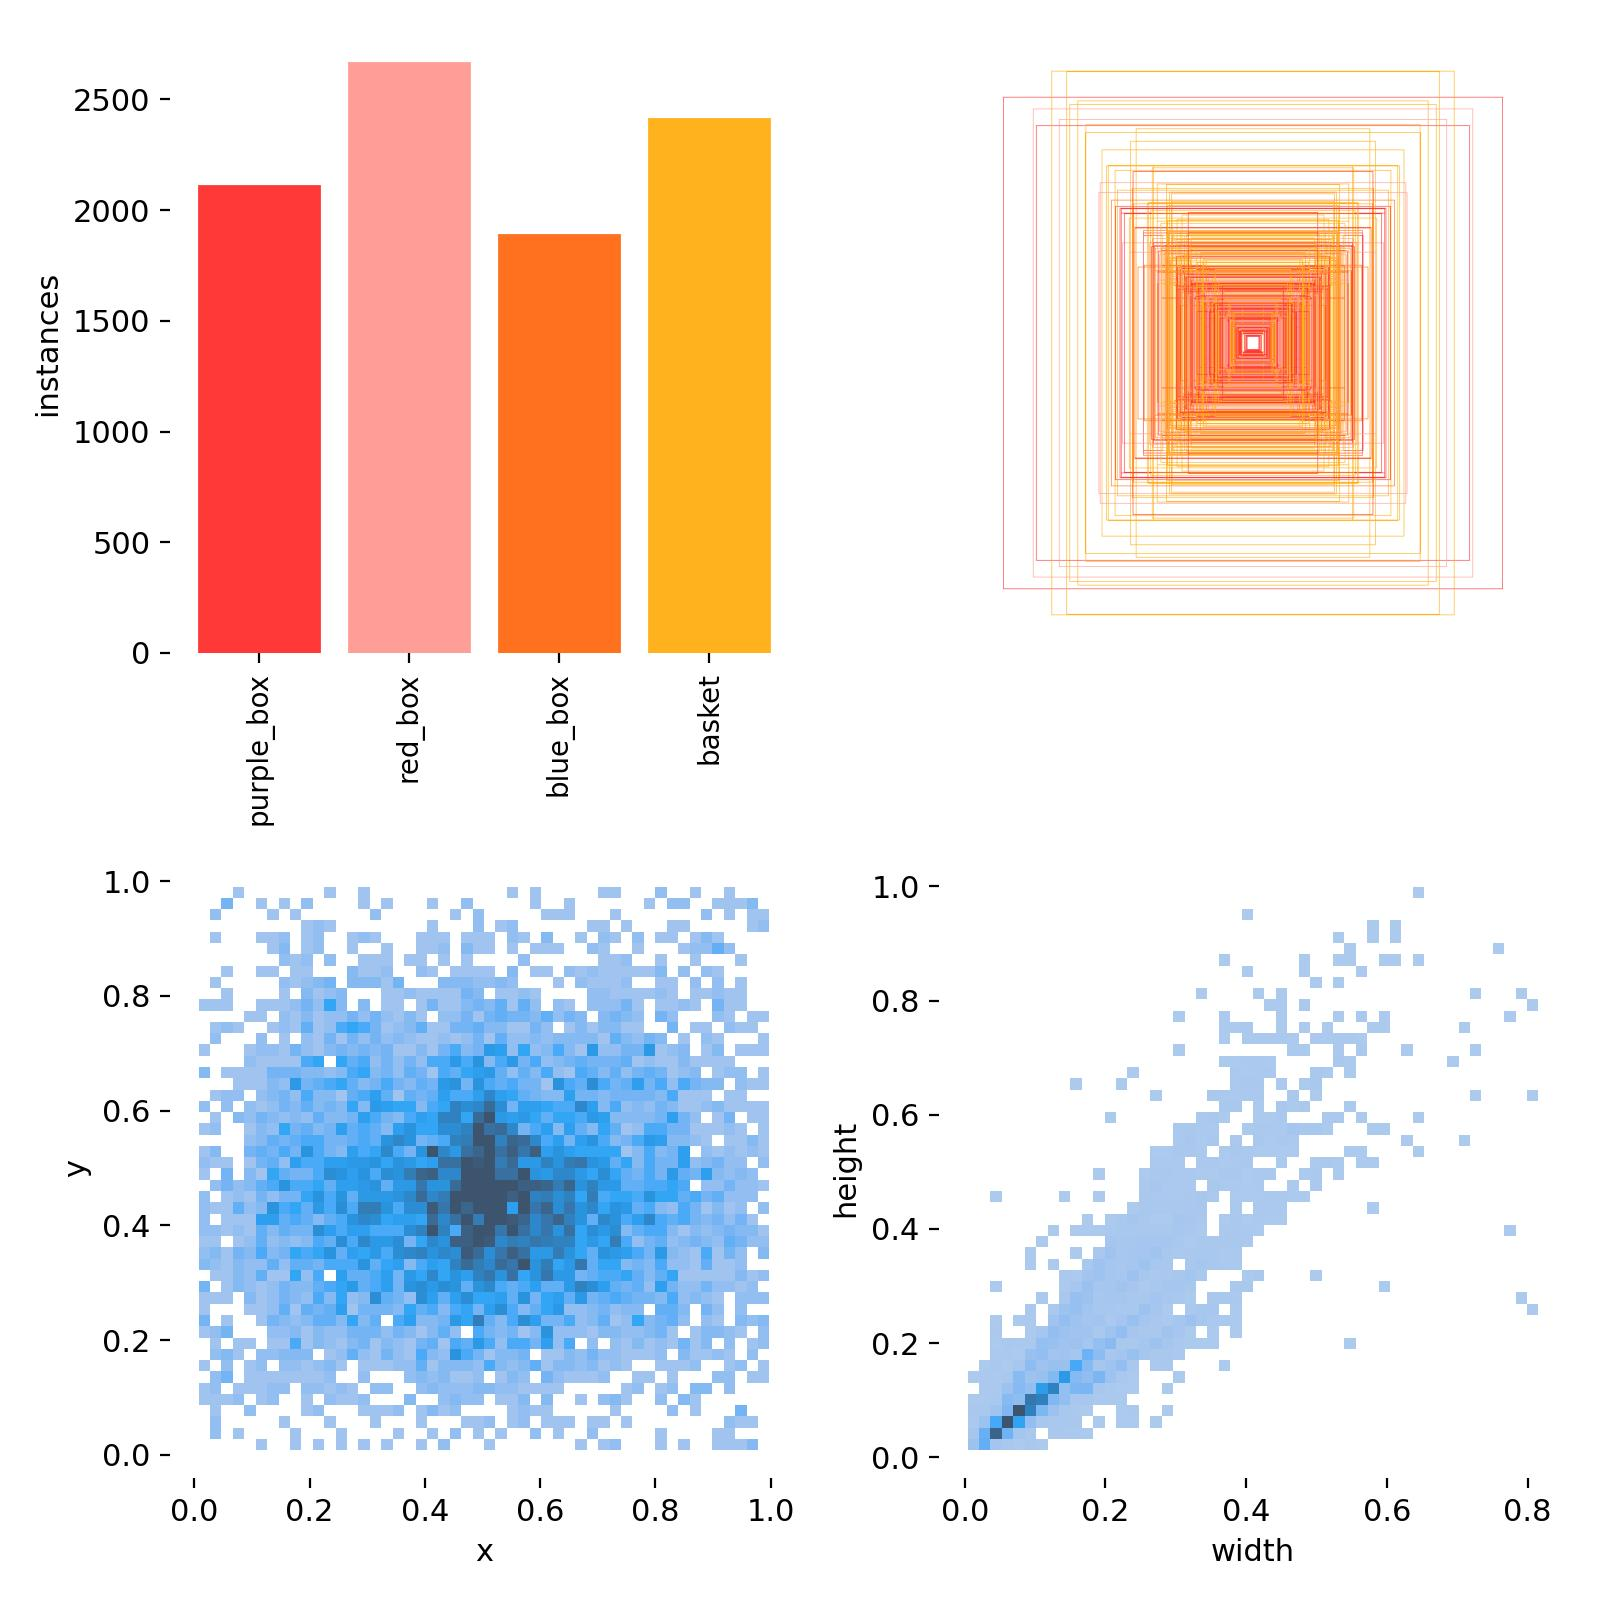
第一张图:
**横坐标:**目标类别ID;
**纵坐标:**每个类别的目标数量,表示该类别在数据集中出现的次数。
**作用:**用来看数据集中每个标签出现的次数,从而判断数据集标签是否均衡,可以根据此修改数据集。
本图在标签分布上就比较不均匀,其中ID为1等的标签相对出现次数相对高,这个不平衡可能影响模型的训练效果的不均衡,尤其是对于较少出现的类别。
第二张图:
本质是将你数据集中所有画的目标框画到了一张图上;
**作用:**可以了解目标框的大小和分布情况,如果目标框的分布过于集中,可能导致模型在特定尺度上的表现优于其他尺度。
本图在小尺度目标框数量远大于大尺度、预测框分布明显趋于中央,就可能导致训练好的模型对小尺度,位于图像中央的目标具有更强的检测能力。
第三张图:
**横坐标:**目标框的中心点在图像宽度方向上的归一化后得到的横坐标;
**纵坐标:**目标框的中心点在图像高度方向上的归一化后得到的纵坐标;
**作用:**通过查看目标框的中心点分布,可以了解目标物体在图像中的位置分布。如果目标中心点集中在图像的某些区域,可能说明数据采集存在偏差。理想情况下,中心点应该较为均匀分布在整个图像中。
第四张图:
**横坐标:**目标框宽度归一化后的得到的宽度;
**纵坐标:**目标框高度归一化后的得到的高度;
**作用:**通过观察宽度的分布,可以了解数据集中的物体尺寸分布。
labels_correlogram.jpg
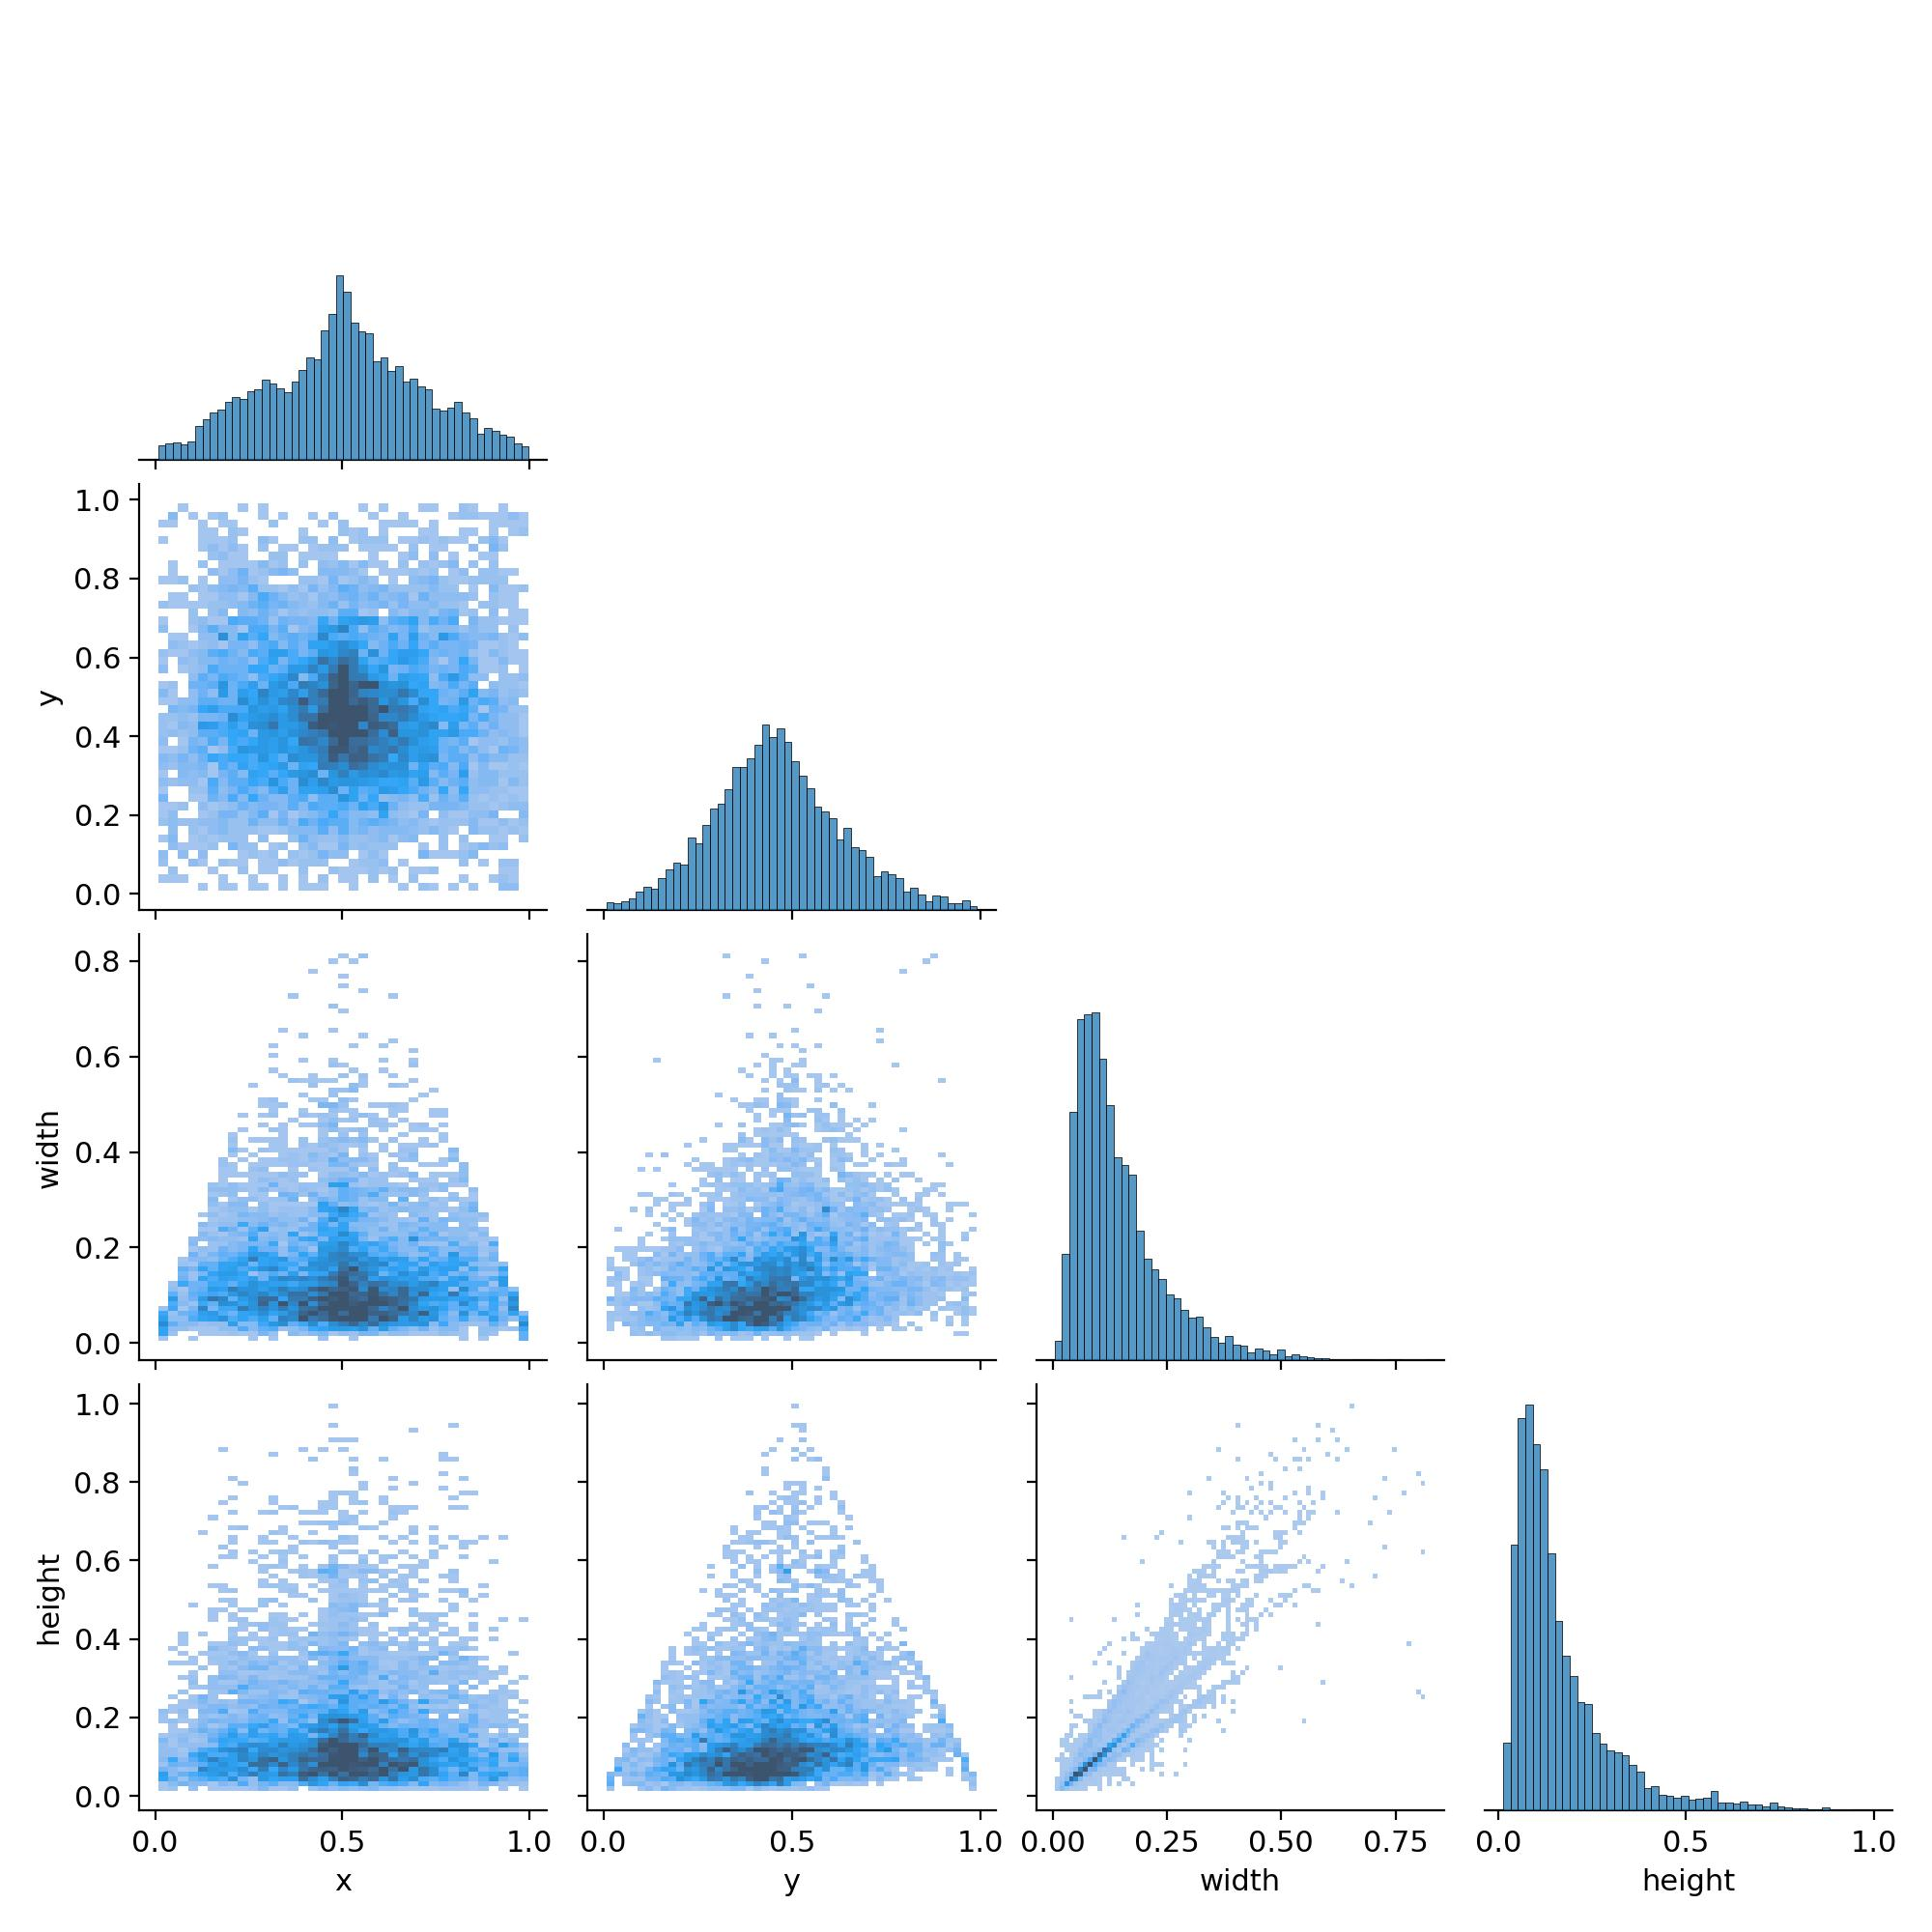
主对角线上的柱状图:展示每个变量的分布。
非主对角线上的散点图:展示两个变量之间的关系。